为什么协整回归的R方不可信?
R方是度量回归模型拟合优度的一个常用指标,但是,对于协整回归,它是完全不可信的。所以,当我们在估计完一个协整回归模型后,如果发现有一个很高的R2,千万不要以为自己发现了一个很棒的模型😂。主要的原因有两点:一、R2对协整回归是没有统计意义的;二、对协整回归,不管自变量的”解释力”如何,R方都会随样本量增大而快速趋向1,这也是为什么我们会发现协整模型的R2都很高的原因。
考虑如下回归模型:$$y_t = \alpha + \beta x_t + u_t \tag{1}$$如果自变量和因变量都是平稳时间序列且误差与自变量不相关,那么,对模型两边取方差,有:$$\sigma_y^2 = \beta^2 \sigma_x^2+ \sigma_u^2 \tag{2}$$所以,自变量带来的方差占因变量方差的比率为\(1 – \sigma_u^2/\sigma_y^2\)。我们所用的R方或调整后的R方,实际上就是这个比率的估计量(很多教科书都没告诉读者这个事)。
如果模型\((1)\)是一个协整回归,那么,我们无法由\((1)\)得到\((2)\),而只能得到:$$\sigma_{y_t}^2 = \beta^2 \sigma_{x_t}^2+ \sigma_{u}^2 \tag{3}$$这是因为当自变量和因变量非平稳时,它们在不同时点的方差(如果存在的话)是不能保证相同的,所以下标\(t\)得保留。因此,R方到底在估计什么,这就没法讲清楚了。
此外,R方的定义为:$$R^2 = 1 -\frac{T^{-1}\sum_{t=1}^T\hat{u}_t^2}{T^{-1}\sum_{t=1}^T(y_t – \bar{y})^2}$$对于协整的情形,分子处的平均会随样本量\(T\)趋于无穷而趋于\(\sigma_u^2\),但分母处的平均,可以证明会随样本量\(T\)趋于无穷而趋于无穷。所以,天下协整一家亲,R方都会向1倾🥲。
下面通过代码展示在数据平稳或非平稳时,R2是如何随样本量增大而变化的。先看平稳的情形:
wfcreate u 3000      '样本量设为3000
rndseed 123456       '设定随机种子
series r2_1          '存放模型1的R方
series r2_2          '存放模型1的R方
equation eq
series u = nrnd      '模型的误差
series x = nrnd      '模型的自变量
series y1 = 1+x+u    '模型1,理论R2为0.5
series y2 = 1+0.5*x+u'模型2,理论R2为0.2
'令样本量从5增长到3000,看R方的变化
for !i = 5 to 3000
  smpl 1 !i
  eq.ls y1 c x
  r2_1(!i) = eq.@r2
  eq.ls y2 c x
  r2_2(!i) = eq.@r2
next
smpl 5 @last
group r2 r2_1 r2_2
r2.line              'R方随样本量的变化图
输出的图如下所示:
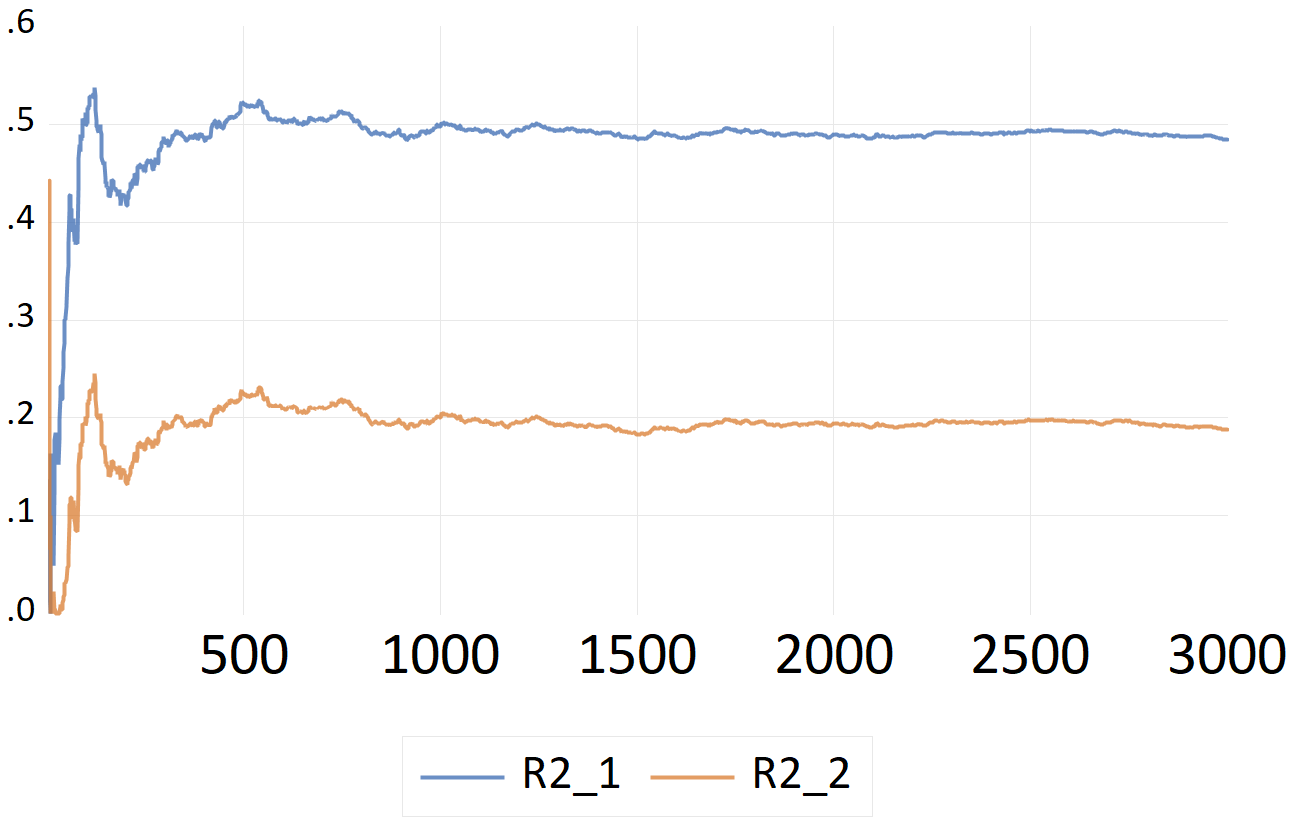
可以看到,两个模型的R2会随样本量增大而趋向各自的理论值。
接下来看看协整的情形:
smpl @all
series e = nrnd
series x = @cumsum(e)'把x设为随机游走
'重复上面平稳情形第8行开始的所有代码
可以得到下图:
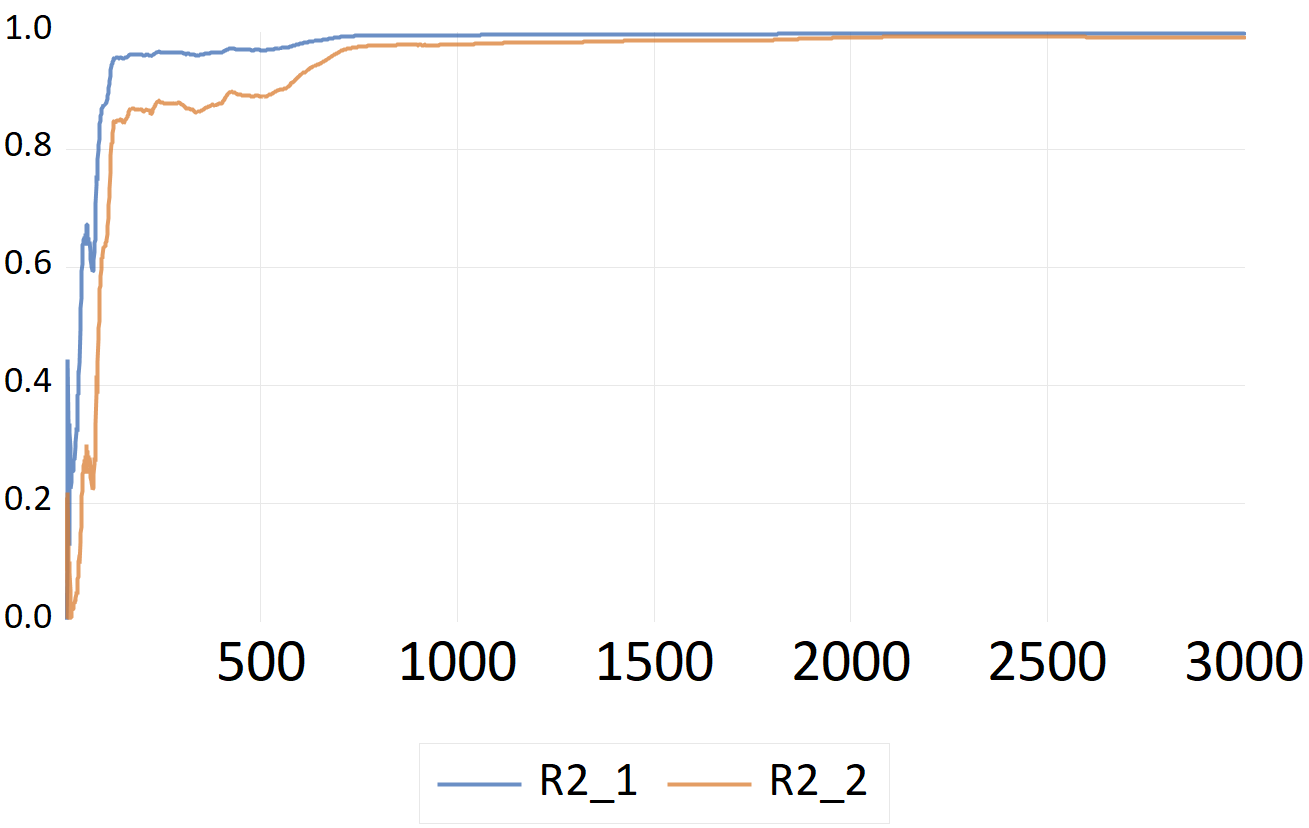
如理论所述,无论自变量的系数是大是小,只要是协整,R方最终都会趋向1。
以上的模拟分析显示,当我们发现协整回归的R方很大时,其实不必对其大书特书。


- 版权声明:本作品使用知识共享(Creative Commons)的署名-非商业性使用-禁止演绎 4.0 国际许可协议。非商业转载请注明出处(作者及原文链接),商业转载请联系作者获得授权。
北京 海淀
13.9℃ 
博文+教程
阅读
给站长留言