主成分分析构建的指数到底是什么?
在实证分析中,主成分分析(PCA)可以用来把多个变量合成一个变量。合成的变量常被视为是一种指数,反映某种经济或金融内涵,例如,投资者情绪、金融稳定性等。其应用过程通常是这样:一、寻找与指数的经济或金融内涵相关的变量;二、通过PCA提取所有变量的第一主成分(也有用上其他主成分的),形成一个单一变量;三、把合成的变量视为反映相应经济或金融内涵的指数。
在上述过程中,第三步是最容易出问题的。由PCA构建的指数能否反映相应的经济或金融内涵,不是PCA这一方法本身能决定的。所以,不能理所当然地认为由PCA提取的第一主成分就是想要的指数,进而直接应用。事实上,PCA提取的第一主成分乘以-1,仍然是第一主成分😥。既然主成分不是唯一的,那么,在软件或程序输出主成分后,直接把主成分拿来用就可能会产生谬误。
为了看清主成分不唯一这一点,假设\(x_1,…,x_k\)是用来合成指数的变量,则由PCA提取的第一主成分为:$$\beta_{11}x_1+\beta_{12}x_2+…+\beta_{1k}x_k$$其中,系数向量\(\beta_1 = (\beta_{11},…,\beta_{1k})’\)是满足如下方程的归一化特征向量:$$\Omega \beta_1 = \lambda_1 \beta_1$$此处的\(\Omega\)是\(x_1,…,x_k\)的协方差矩阵或相关矩阵,\(\lambda_1\)是\(\Omega\)的最大特征根。容易看出,\(\beta_1\)和\(-\beta_1\)都是上述方程的解,所以,第一主成分不是唯一的,另一个第一主成分为:$$-\beta_{11}x_1-\beta_{12}x_2-…-\beta_{1k}x_k$$
由于主成分的不唯一性,不同软件或程序输出的主成分可能是不同的。以EViews和R为例,请看以下代码:
wfcreate u 6666   '样本量设为6666
rndseed 123456
'生成5个变量
series x1 = nrnd
series x2 = -@exp(3+nrnd)*x1+nrnd
series x3 = @sin(x2) + x1 + nrnd
series x4 = x3^2/x2 + nrnd
series x5 = -x3*@cos(x4) + x2*nrnd
group x x1 x2 x3 x4 x5
'基于协方差矩阵,使用pcomp进行主成分分析,获得特征向量eigv0
x.pcomp(eigvec=eigv0, cov=cov)
'打开R连接
XOPEN(type=r)
'把x发送给R,存为名为vars的数据框
XPUT(rtype=data.frame, name=vars) x
'使用R的prcomp进行主成分分析,获得特征向量eigv1
XRUN eigv1 = prcomp(vars)$rotation
'使用R的princomp进行主成分分析,获得特征向量eigv2
XRUN eigv2 = princomp(vars)$loadings
'把eigv1和eigv2取回EViews
XGET(name=eigv1, type=matrix) eigv1
XGET(name=eigv2, type=matrix) eigv2
'关闭R连接
XCLOSE(type=r)上述代码对5个生成的变量进行了主成分分析,由EViews的pcomp命令得到的特征向量存在eigv0里,由R的prcomp和princomp函数得到的特征向量分别存在eigv1和eigv2里,结果如下:
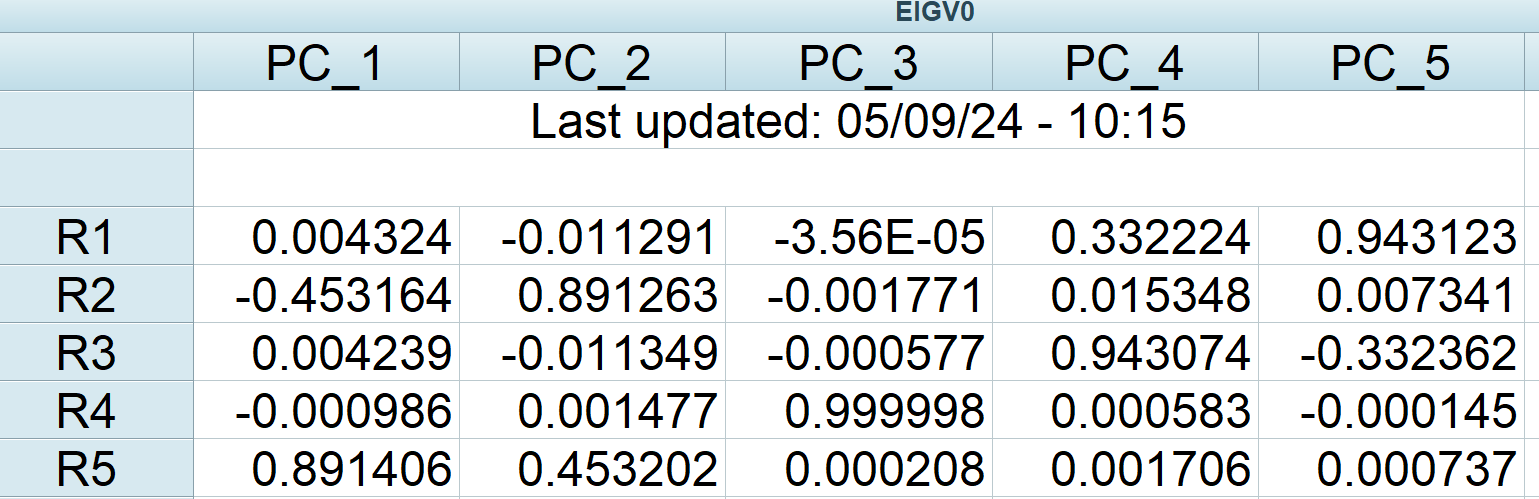
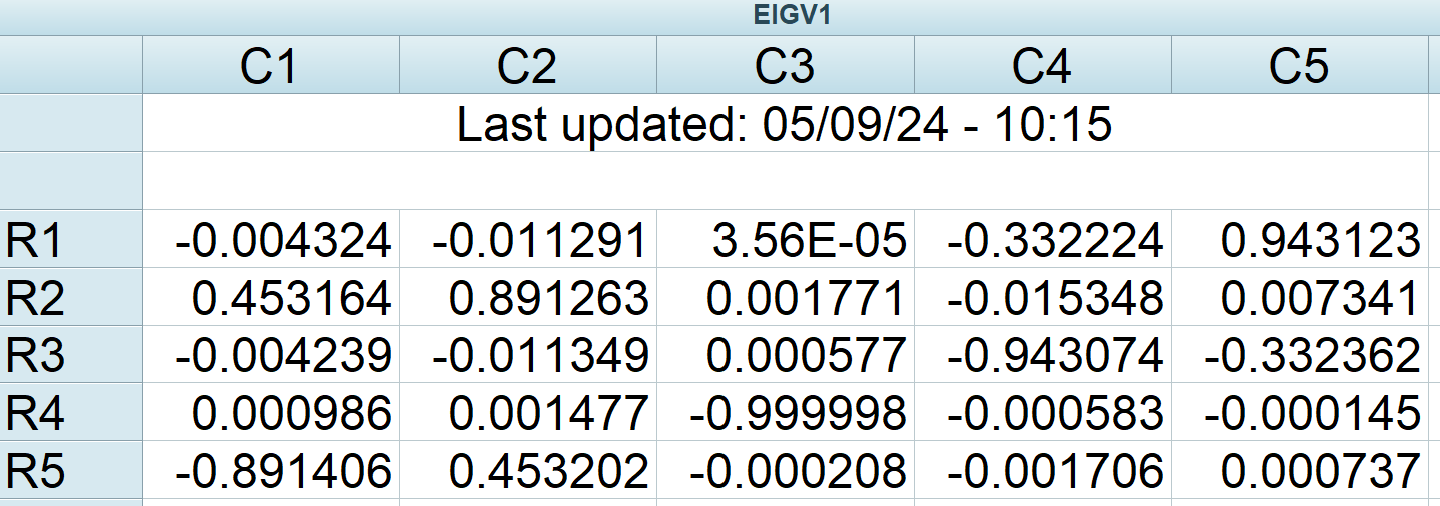
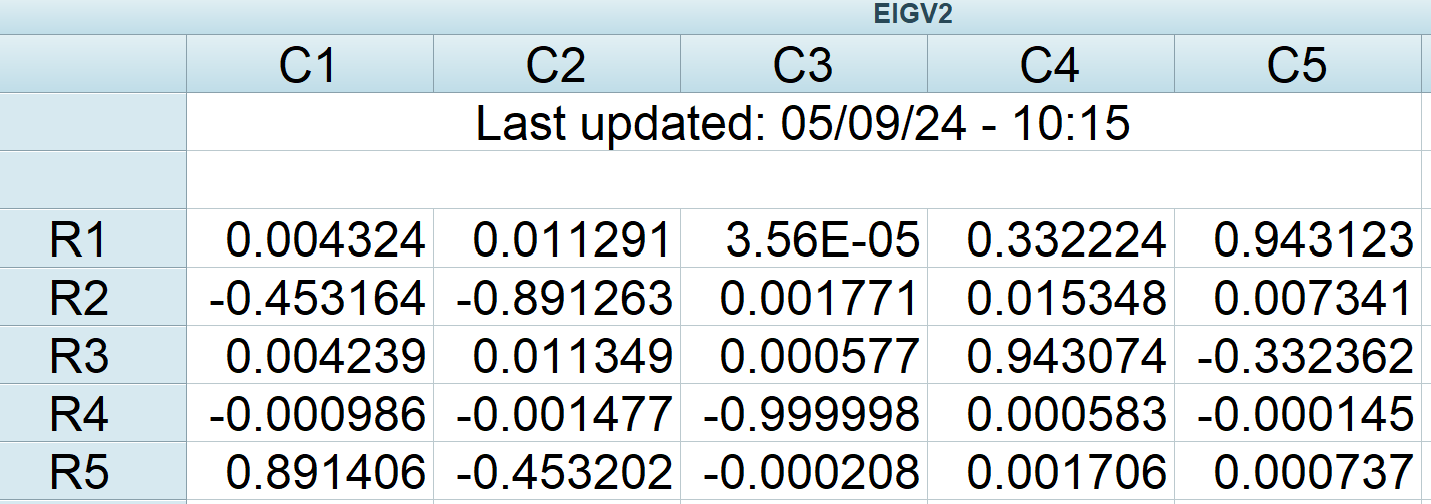
可以看到,eigv0和eigv2相同,但都与eigv1不同。所以,当我们想要赋予主成分某种内涵时,一定要特别注意软件或程序的输出是否合理。
另一个需要注意的点,也是更重要的点是:在提取出主成分后,一定要对它是否能反映特定的经济或金融内涵做进一步的分析和检验。往往,这一步需要结合历史事实才能实现。Baker和Wurgler于2006年在《Journal of Finance》发表的“Investor sentiment and the cross‐section of stock returns”是一个相当好的例子,可以参考。
综上所述,主成分分析虽然能用来构建指数,但是,由软件或程序输出的结果不是天然就是想要的指数。如果没有注意到主成分的不唯一性,如果没有对主成分的内涵做进一步的分析和检验,那么,由主成分分析构建的指数到底是什么,就只有老天爷知道了😂。


- 版权声明:本作品使用知识共享(Creative Commons)的署名-非商业性使用-禁止演绎 4.0 国际许可协议。非商业转载请注明出处(作者及原文链接),商业转载请联系作者获得授权。
北京 海淀
13.9℃ 
博文+教程
阅读
给站长留言