为什么协整回归的R方不可信?
R方是度量回归模型拟合优度的一个常用指标,但是,对于协整回归,它是完全不可信的。所以,当我们在估计完一个协整回归模型后,如果发现有一个很高的R2,千万不要以为自己发现了一个很棒的模型😂。主要的原因有两点:一、R2对协整回归是没有统计意义的;二、对协整回归,不管自变量的”解释力”如何,R方都会随样本量增大而快速趋向1,这也是为什么我们会发现协整模型的R2都很高的原因。
考虑如下回归模型:$$y_t = \alpha + \beta x_t + u_t \tag{1}$$如果自变量和因变量都是平稳时间序列且误差与自变量不相关,那么,对模型两边取方差,有:$$\sigma_y^2 = \beta^2 \sigma_x^2+ \sigma_u^2 \tag{2}$$所以,自变量带来的方差占因变量方差的比率为\(1 – \sigma_u^2/\sigma_y^2\)。我们所用的R方或调整后的R方,实际上就是这个比率的估计量(很多教科书都没告诉读者这个事)。
如果模型\((1)\)是一个协整回归,那么,我们无法由\((1)\)得到\((2)\),而只能得到:$$\sigma_{y_t}^2 = \beta^2 \sigma_{x_t}^2+ \sigma_{u}^2 \tag{3}$$这是因为当自变量和因变量非平稳时,它们在不同时点的方差(如果存在的话)是不能保证相同的,所以下标\(t\)得保留。因此,R方到底在估计什么,这就没法讲清楚了。
此外,R方的定义为:$$R^2 = 1 -\frac{T^{-1}\sum_{t=1}^T\hat{u}_t^2}{T^{-1}\sum_{t=1}^T(y_t – \bar{y})^2}$$对于协整的情形,分子处的平均会随样本量\(T\)趋于无穷而趋于\(\sigma_u^2\),但分母处的平均,可以证明会随样本量\(T\)趋于无穷而趋于无穷。所以,天下协整一家亲,R方都会向1倾🥲。
下面通过代码展示在数据平稳或非平稳时,R2是如何随样本量增大而变化的。先看平稳的情形:
wfcreate u 3000      '样本量设为3000
rndseed 123456       '设定随机种子
series r2_1          '存放模型1的R方
series r2_2          '存放模型1的R方
equation eq
series u = nrnd      '模型的误差
series x = nrnd      '模型的自变量
series y1 = 1+x+u    '模型1,理论R2为0.5
series y2 = 1+0.5*x+u'模型2,理论R2为0.2
'令样本量从5增长到3000,看R方的变化
for !i = 5 to 3000
  smpl 1 !i
  eq.ls y1 c x
  r2_1(!i) = eq.@r2
  eq.ls y2 c x
  r2_2(!i) = eq.@r2
next
smpl 5 @last
group r2 r2_1 r2_2
r2.line              'R方随样本量的变化图
输出的图如下所示:
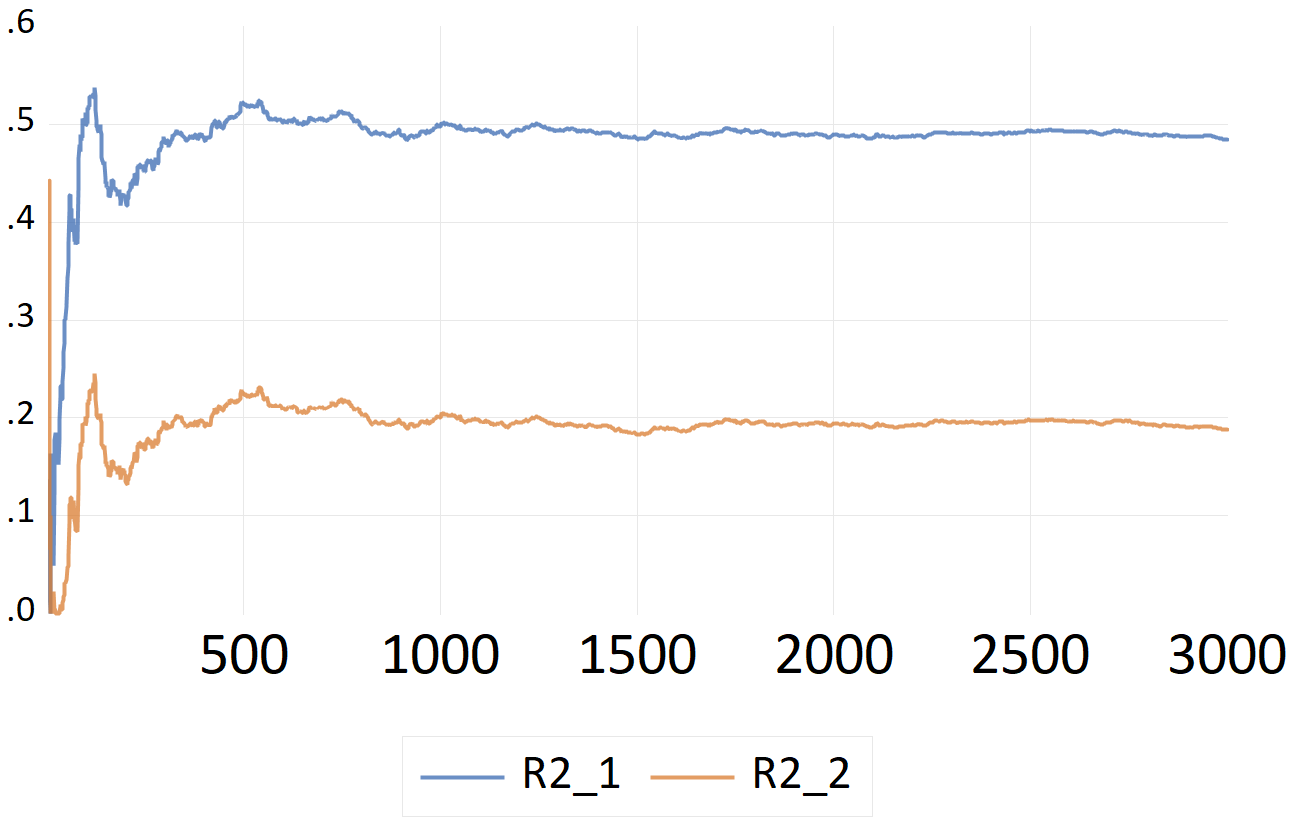
可以看到,两个模型的R2会随样本量增大而趋向各自的理论值。
接下来看看协整的情形:
smpl @all
series e = nrnd
series x = @cumsum(e)'把x设为随机游走
'重复上面平稳情形第8行开始的所有代码
可以得到下图:
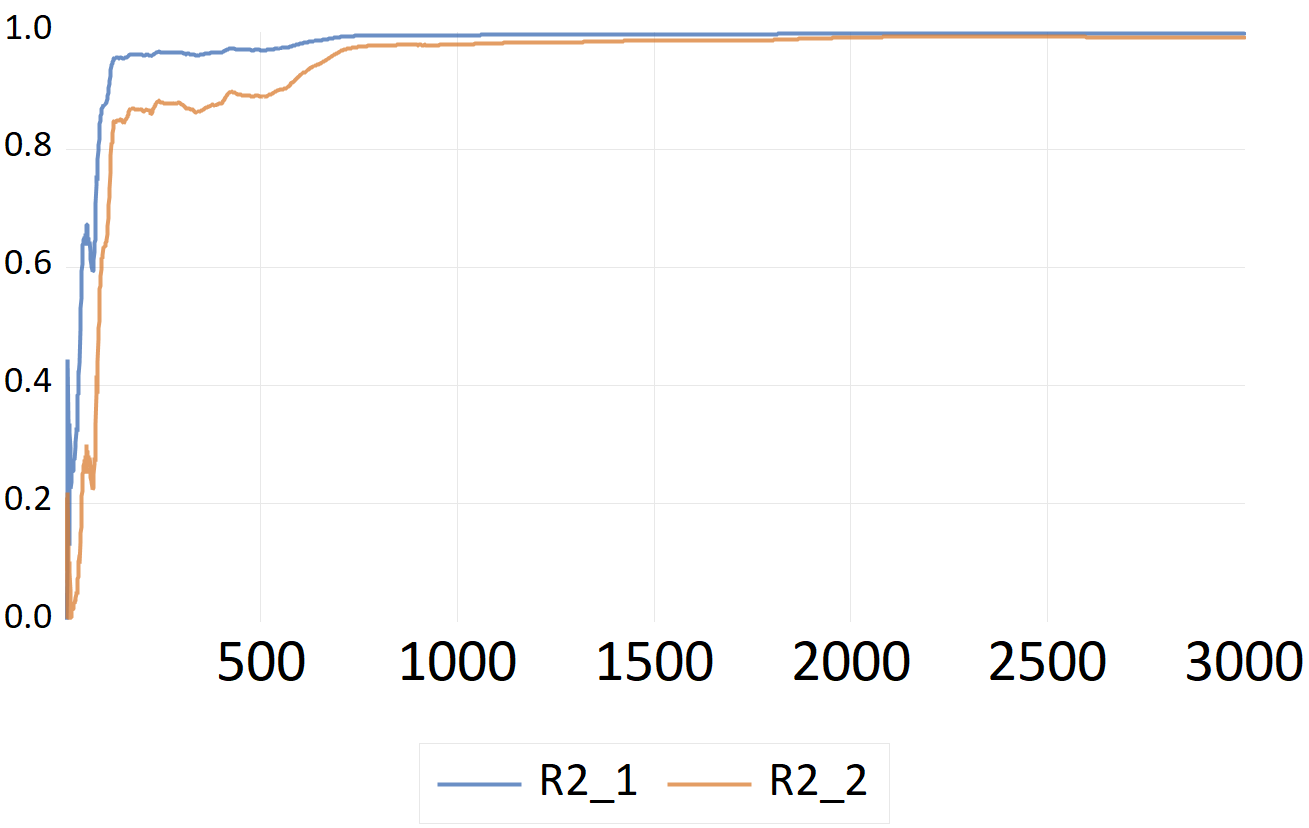
如理论所述,无论自变量的系数是大是小,只要是协整,R方最终都会趋向1。
以上的模拟分析显示,当我们发现协整回归的R方很大时,其实不必对其大书特书。
主成分分析构建的指数到底是什么?
在实证分析中,主成分分析(PCA)可以用来把多个变量合成一个变量。合成的变量常被视为是一种指数,反映某种经济或金融内涵,例如,投资者情绪、金融稳定性等。其应用过程通常是这样:一、寻找与指数的经济或金融内涵相关的变量;二、通过PCA提取所有变量的第一主成分(也有用上其他主成分的),形成一个单一变量;三、把合成的变量视为反映相应经济或金融内涵的指数。
在上述过程中,第三步是最容易出问题的。由PCA构建的指数能否反映相应的经济或金融内涵,不是PCA这一方法本身能决定的。所以,不能理所当然地认为由PCA提取的第一主成分就是想要的指数,进而直接应用。事实上,PCA提取的第一主成分乘以-1,仍然是第一主成分😥。既然主成分不是唯一的,那么,在软件或程序输出主成分后,直接把主成分拿来用就可能会产生谬误。
为了看清主成分不唯一这一点,假设\(x_1,…,x_k\)是用来合成指数的变量,则由PCA提取的第一主成分为:$$\beta_{11}x_1+\beta_{12}x_2+…+\beta_{1k}x_k$$其中,系数向量\(\beta_1 = (\beta_{11},…,\beta_{1k})’\)是满足如下方程的归一化特征向量:$$\Omega \beta_1 = \lambda_1 \beta_1$$此处的\(\Omega\)是\(x_1,…,x_k\)的协方差矩阵或相关矩阵,\(\lambda_1\)是\(\Omega\)的最大特征根。容易看出,\(\beta_1\)和\(-\beta_1\)都是上述方程的解,所以,第一主成分不是唯一的,另一个第一主成分为:$$-\beta_{11}x_1-\beta_{12}x_2-…-\beta_{1k}x_k$$
由于主成分的不唯一性,不同软件或程序输出的主成分可能是不同的。以EViews和R为例,请看以下代码:
wfcreate u 6666   '样本量设为6666
rndseed 123456
'生成5个变量
series x1 = nrnd
series x2 = -@exp(3+nrnd)*x1+nrnd
series x3 = @sin(x2) + x1 + nrnd
series x4 = x3^2/x2 + nrnd
series x5 = -x3*@cos(x4) + x2*nrnd
group x x1 x2 x3 x4 x5
'基于协方差矩阵,使用pcomp进行主成分分析,获得特征向量eigv0
x.pcomp(eigvec=eigv0, cov=cov)
'打开R连接
XOPEN(type=r)
'把x发送给R,存为名为vars的数据框
XPUT(rtype=data.frame, name=vars) x
'使用R的prcomp进行主成分分析,获得特征向量eigv1
XRUN eigv1 = prcomp(vars)$rotation
'使用R的princomp进行主成分分析,获得特征向量eigv2
XRUN eigv2 = princomp(vars)$loadings
'把eigv1和eigv2取回EViews
XGET(name=eigv1, type=matrix) eigv1
XGET(name=eigv2, type=matrix) eigv2
'关闭R连接
XCLOSE(type=r)上述代码对5个生成的变量进行了主成分分析,由EViews的pcomp命令得到的特征向量存在eigv0里,由R的prcomp和princomp函数得到的特征向量分别存在eigv1和eigv2里,结果如下:
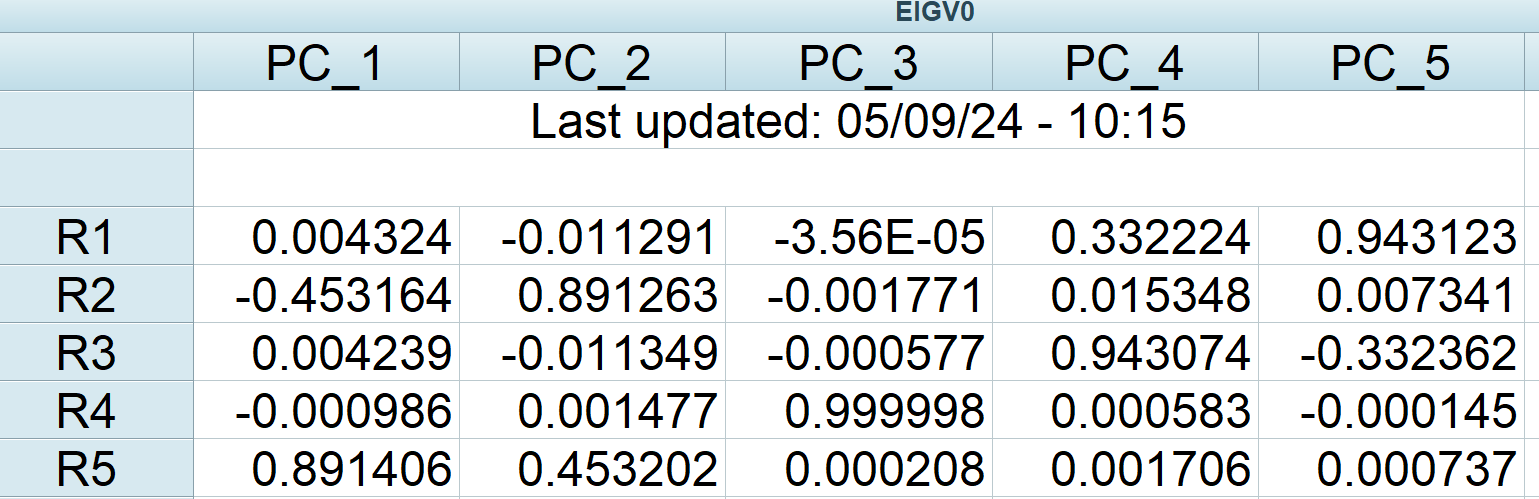
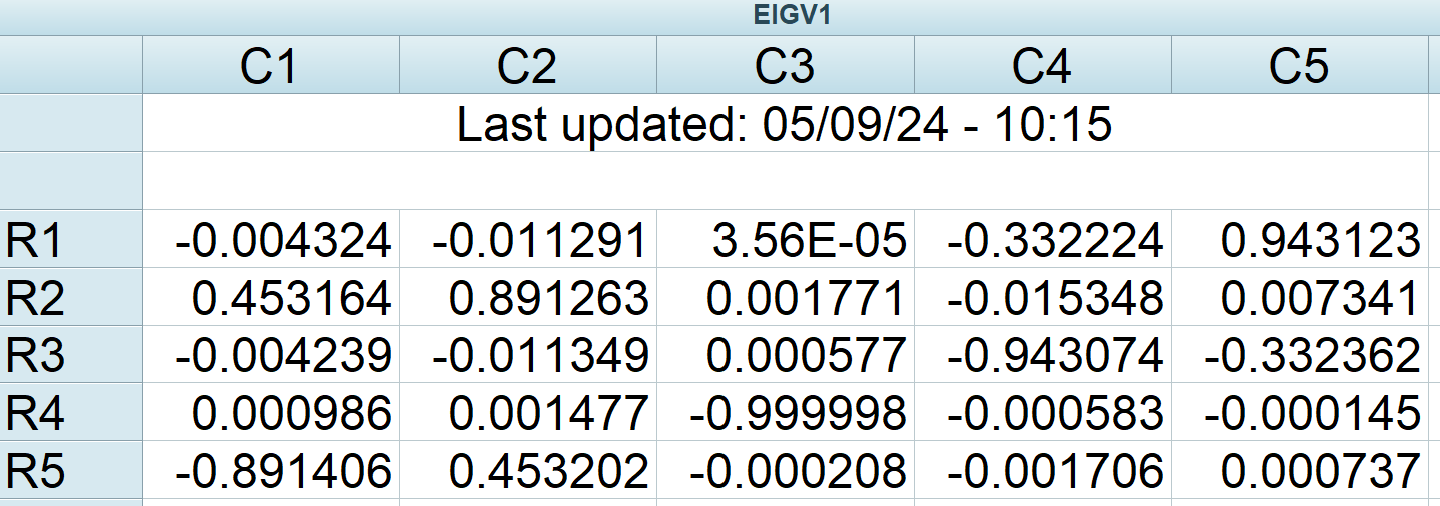
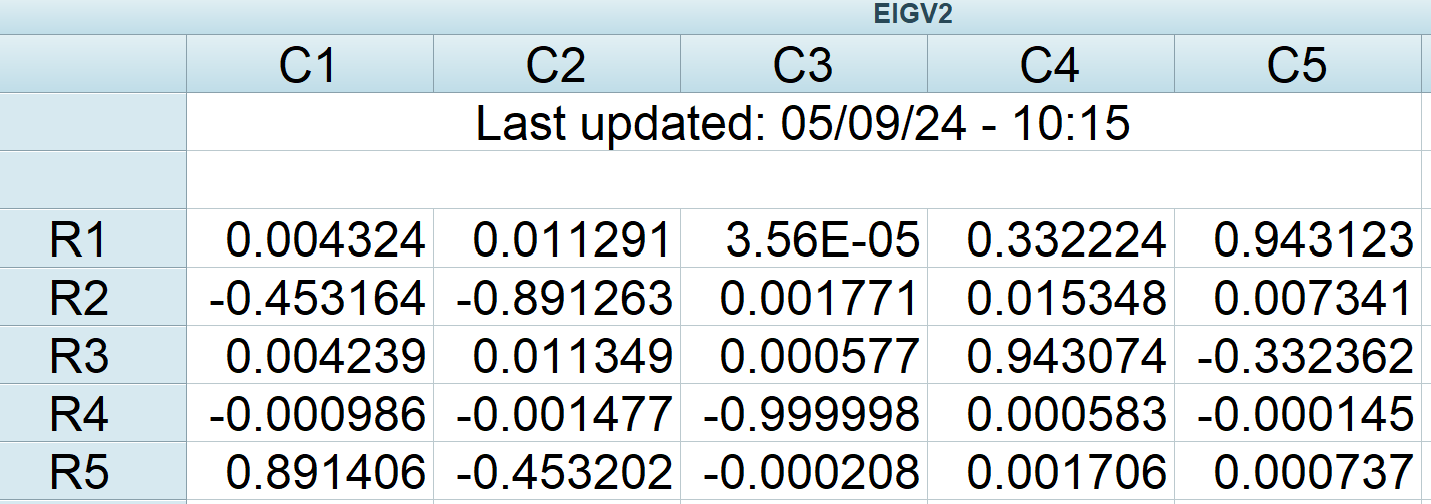
可以看到,eigv0和eigv2相同,但都与eigv1不同。所以,当我们想要赋予主成分某种内涵时,一定要特别注意软件或程序的输出是否合理。
另一个需要注意的点,也是更重要的点是:在提取出主成分后,一定要对它是否能反映特定的经济或金融内涵做进一步的分析和检验。往往,这一步需要结合历史事实才能实现。Baker和Wurgler于2006年在《Journal of Finance》发表的“Investor sentiment and the cross‐section of stock returns”是一个相当好的例子,可以参考。
综上所述,主成分分析虽然能用来构建指数,但是,由软件或程序输出的结果不是天然就是想要的指数。如果没有注意到主成分的不唯一性,如果没有对主成分的内涵做进一步的分析和检验,那么,由主成分分析构建的指数到底是什么,就只有老天爷知道了😂。
相关系数矩阵能“检测”多重共线性吗?
在实证研究中,解释变量的相关系数矩阵常被视为是一种“检测”多重共线性的工具。在应用上通常是这样:当存在大于某一数值(如0.7)的相关系数时,表明解释变量间存在近似多重共线性问题,因此解释变量不易同时放入回归模型中;当所有的相关系数都较小时,则不存在多重共线性问题,因此解释变量可以都放入回归模型中。
事实上,相关系数矩阵只能提供多重共线性存在的证据,而不能提供多重共线性不存在的证据:当存在较大的相关系数时,近似多重共线性可能存在;当所有相关系数都较小时,不代表不存在多重共线性问题。原理很简单:多重共线性是一个多变量问题,而相关系数只能反映两变量间的线性相关关系,局部相关性不强不代表全局相关性不强。
举个例子,令\(u_1,…,u_{12}\)为12个独立同分布的随机变量,定义如下\(x_1,…,x_6\):$$\begin{array}{l}
x_1 = u_1+u_2+u_3+u_4 \\
x_2 = u_4+u_5+u_6+u_7 \\
x_3 = u_7+u_8+u_9+u_{10} \\
x_4 = u_1+u_{10}+u_{11}+u_{12} \\
x_5 = u_2-u_5+u_8-u_{11}\\
x_6 = u_3-u_6+u_9-u_{12}\\
\end{array}$$显然,这6个变量两两之间的相关系数要么为0,要么为0.25或-0.25。如果从相关系数矩阵来看,这6个变量是不存在多重共线性的。但是,容易验证:$$x_1-x_2+x_3-x_4-x_5-x_6=0$$所以,事实上这6个变量是完全共线的😥。
我们可以利用EViews来模拟上面的例子,代码如下:
wfcreate u 6666    '样本量设为6666
string u
rndseed 123456
for !i = 1 to 12   '生成12个独立的N(0,1)变量并抽样
    u = "u"+@str(!i)
    series {u} = nrnd
next
'生成6个解释变量
series x1 = u1+u2+u3+u4
series x2 = u4+u5+u6+u7
series x3 = u7+u8+u9+u10
series x4 = u1+u10+u11+u12
series x5 = u2-u5+u8-u11
series x6 = u3-u6+u9-u12
group x x1 x2 x3 x4 x5 x6
'生成相关系数矩阵
x.cov(outfmt=single) corr
'生成被解释变量并做回归
series y = nrnd
equation eq1.ls y c x1 x2 x3 x4 x5 x6
输出的相关系数矩阵为:
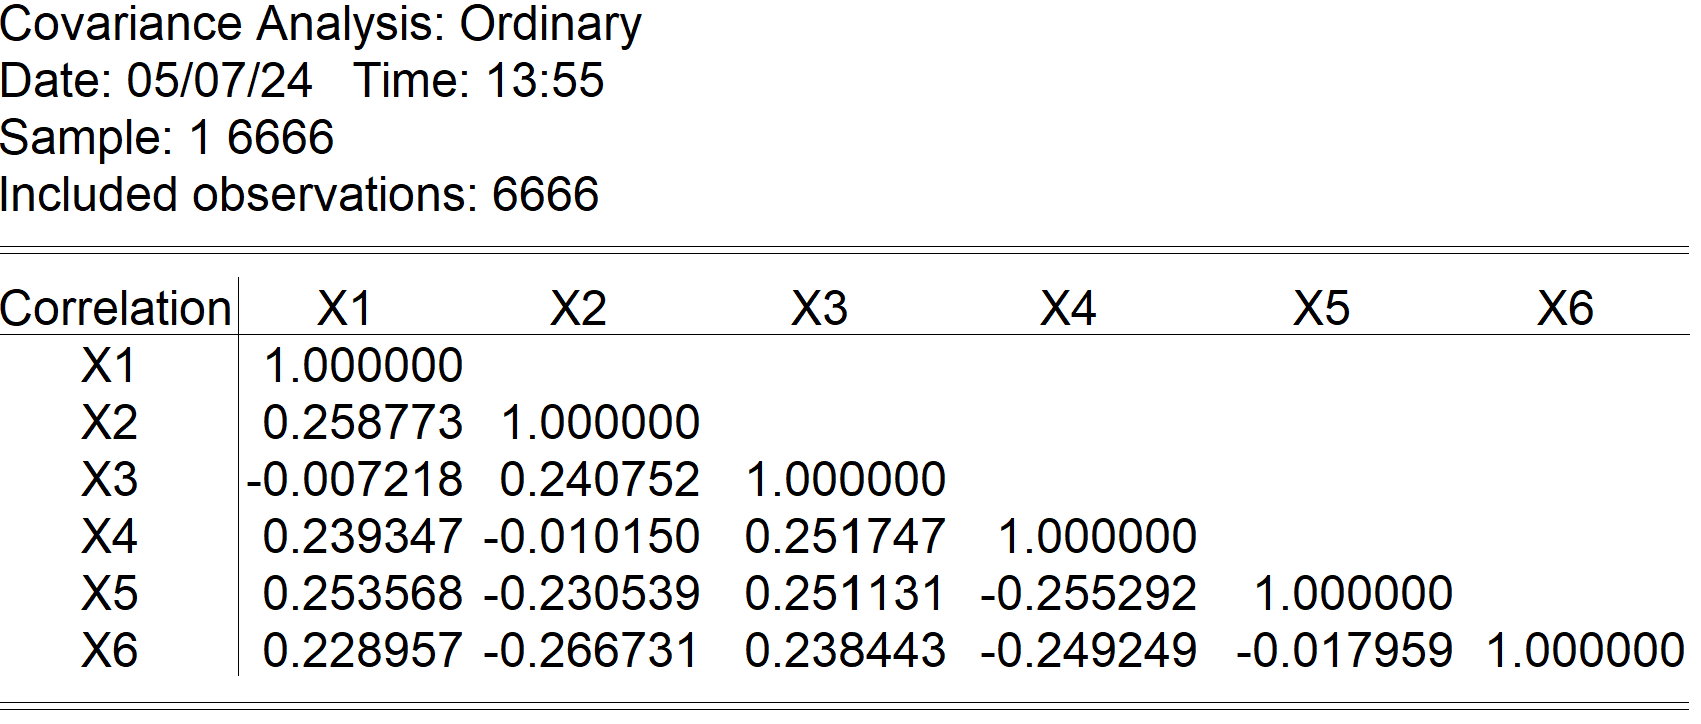
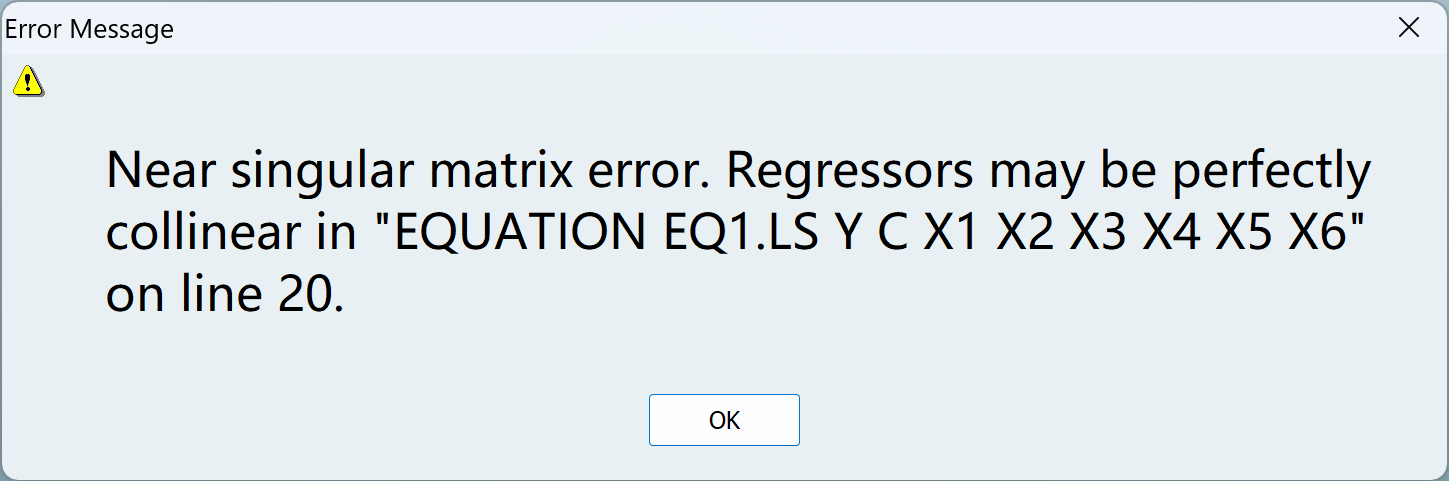
可以看到,所有的相关系数都不大。但是,当我们进行回归时,EViews会提示解释变量间存在完全多重共线性:
前言
欢迎留言,欢迎纠错,欢迎建议,欢迎转载。🌻🌻🌻
在经济学实证分析中,普遍存在计量或统计模型和方法被误用的情形。根据我多年的评审经验,学生写的论文中,误用现象尤为严重。在这个文档中,我将对一些典型(反复出现)的误用进行解释说明。为了降低阅读难度,我对模型和方法背后的理论尽量不做过多的介绍,但是,我会利用具体的数据实例或随机模拟来弥补在理论上的“吝啬”。这一部分内容我会优先考虑使用EViews来实现,如果你对EViews不太了解,可以通过EViews教程来学习。
北京 海淀
13.9℃ 
博文+教程
阅读
市场行情
- 上证指数
- 深证成指
- 创业板指
- 国债指数