平滑过渡回归模型
平滑过渡回归(smooth transition regression,STR)模型是这样一种模型:$$y_t = x_t’\beta+z_t’\alpha+G(q_t|\delta,c)z_t’\gamma +u_t$$模型中\(z_t\)的系数(向量)为某一阈值变量\(q_t\)的函数:$$\alpha+G(q_t|\delta,c)\gamma$$其中,\(q_t\)通过过渡函数(transition function)\(G(\cdot|\delta,c)\)来影响\(z_t\)对\(y_t\)的边际影响,\(\delta\)为斜率参数,\(c\)为阈值参数,\(\alpha\)为\(z_t\)线性部分的系数,\(\gamma\)为\(z_t\)非线性部分的系数。
如果\(G(\cdot|\delta,c)\)取离散值的话,显然,STR就是离散阈值回归。所以,在EViews中,STR模型的估计也使用threshold命令。在STR模型中,\(G(\cdot|\delta,c)\)是一个取值在(0,1)间的连续函数,这也是”平滑过渡“的含义。
模型估计
EViews中提供以下四种过渡函数以供使用,它们分别对应逻辑斯特STR模型、指数STR模型、正态STR模型和二阶逻辑斯特STR模型。
Logistic:$$G(s|\delta,c)=\frac{1}{1+e^{-\delta(s-c)}}$$
Exponential:$$G(s|\delta,c)=1-e^{-\delta(s-c)^2}$$
Normal:$$G(s|\delta,c)=\Phi(\delta(s-c))$$ $$\Phi(\cdot)\text{为标准正态分布的累积分布函数}$$
Logistic, second-order:$$G(s|\delta,c)=\frac{1}{1+e^{-\delta(s-c_1)(s-c_2)}}$$
threshold命令的用法与估计离散阈值回归类似,只需令参数type=smooth即可。默认状态下,EViews会估计逻辑斯特STR模型,估计另外三种STR模型需要设参数smoothtrans分别为exponential、normal或logistic2。例如:
smpl 1953m01 1990m12
equation eq1.threshold(type=smooth) cp c fygt10(-1 to -2) @thresh 1 2
估计结果如下:
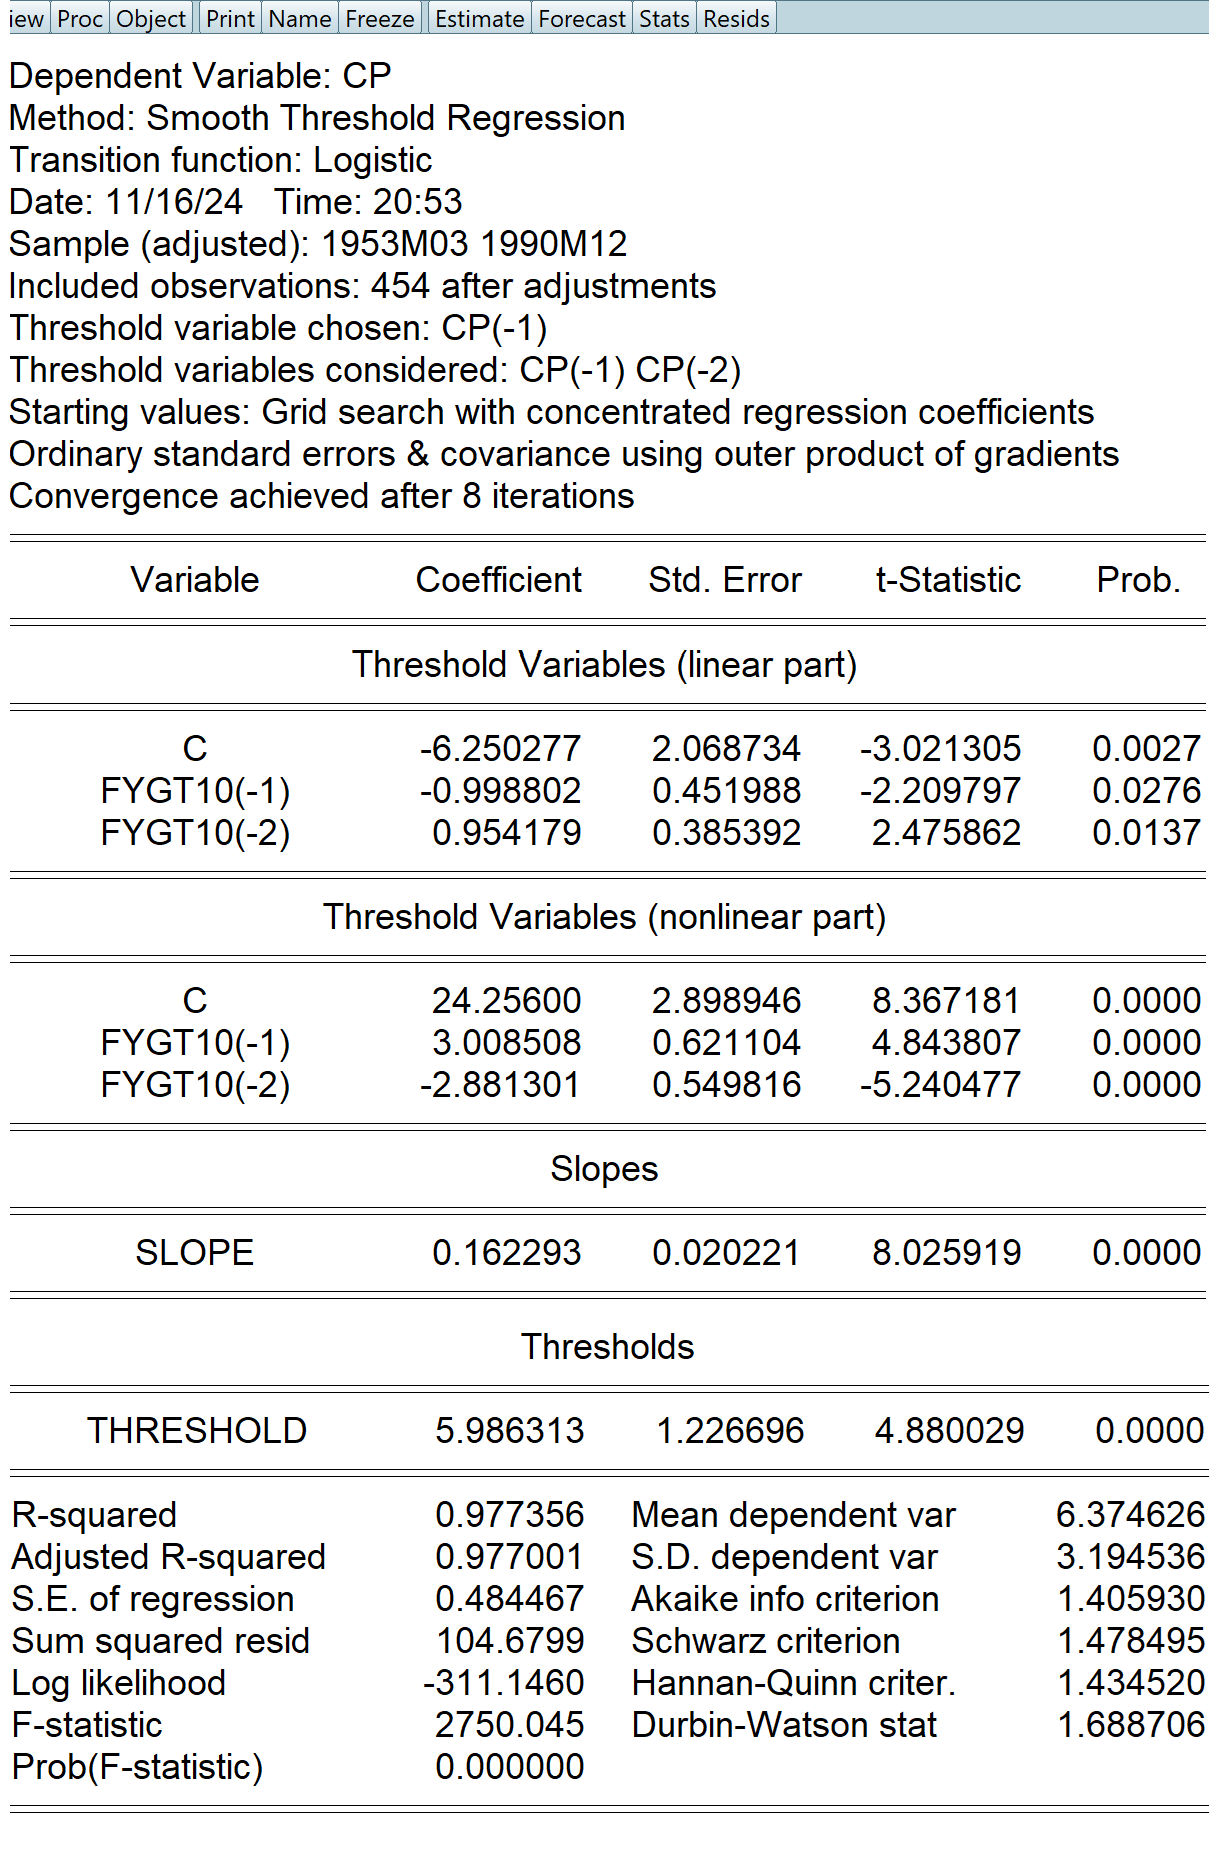
估计结果显示,最优的阈值变量为\(cp_{t-1}\),斜率参数的估计值为0.162293,阈值参数的估计值为5.986313。
对某一自变量,如果只想保留它非线性部分的系数而不要其线性部分的系数(也就是将系数强制设为0),那么,只需在代码中将其套上@alt即可。例如:
equation eq1.threshold(type=smooth) cp c fygt10(-1) @alt(fygt10(-2)) @thresh 1 2线性检验
对STR模型,一个很重要的问题是:是否有必要引入导致模型非线性的过渡函数。对这一问题,我们可以通过线性检验(linearity tests)得到答案。线性检验的原理很简单,就是检验\(\delta=0\),但是,我们不能通过估计结果中“SLOPE”一行的p值来做这一检验,原因是在此原假设下,\(c\)和\(\gamma\)是无法被识别的。所以,这不是一个常规的检验(那个p值是错的😂)。进行线性检验使用的命令为strlinear,用法为:
eq1.strlinear命令复习
(.)threshold(type=smooth):估计平滑过渡回归模型.strlinear:对STR模型进行线性检验
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 把上面的逻辑斯特STR模型改为二阶逻辑斯特STR模型并估计,两个阈值参数的估计是多少?它们显著吗?
离散阈值回归模型
离散阈值回归(discrete threshold regression)也叫离散门槛回归,是这样一种回归模型:模型中某些自变量的系数取值依赖于某个变量(被称为阈值变量或门槛变量)且呈离散状态(有限个)。该模型可表达为:$$y_t = x_t’\beta+z_t’\gamma_s+u_t \quad \text{ if } \quad \delta_s \leq q_t < \delta_{s+1}$$其中,\(q_t\)为阈值变量,\(\delta_1,\cdots,\delta_m\)为\(m\)个阈值参数,\(\delta_0=-\infty\),\(\delta_{m+1}=+\infty\)。显然,当\(q_t\)取不同值时,\(z_t\)对\(y_t\)的边际影响可能是不同的。
估计离散阈值回归模型需要设定离散参数的个数\(m\),在EViews中,\(m\)可以通过假设检验的方式自动确定(相关检验请参看EViews的指南),当然,也可以自行设定。在EViews中,也可以同时提供多个阈值变量,由软件自动选择最优的一个(对应最小的残差平方和)。
在EViews中,估计离散阈值回归模型需要使用threshold命令。打开EViews安装目录下的Example Files\EV13 Manual Data\Chapter 05 – Basic Data Handling\bonds.wf1,如果我们要估计如下模型:$$cp_t = \phi_{0s} +\sum_{i=1}^3\phi_{is}cp_{t-i} + \beta fygt10_t+u_t$$且选择\(cp_{t-1}\)、\(cp_{t-2}\)、\(cp_{t-3}\)或\(cp_{t-4}\)为阈值变量,那么,可以执行如下代码:
smpl 1953m01 1990m12
equation eq1.threshold cp c cp(-1 to -3) @nv fygt10 @thresh 1 4
代码中的@nv(non-varying之意)用来声明系数不受阈值变量影响的变量,@thresh用来设定备选的阈值变量:“1 4”表示因变量的一到四阶滞后为备选阈值变量,”1 4″也可以等价写为”cp(-1 to -4)”。估计结果如下:
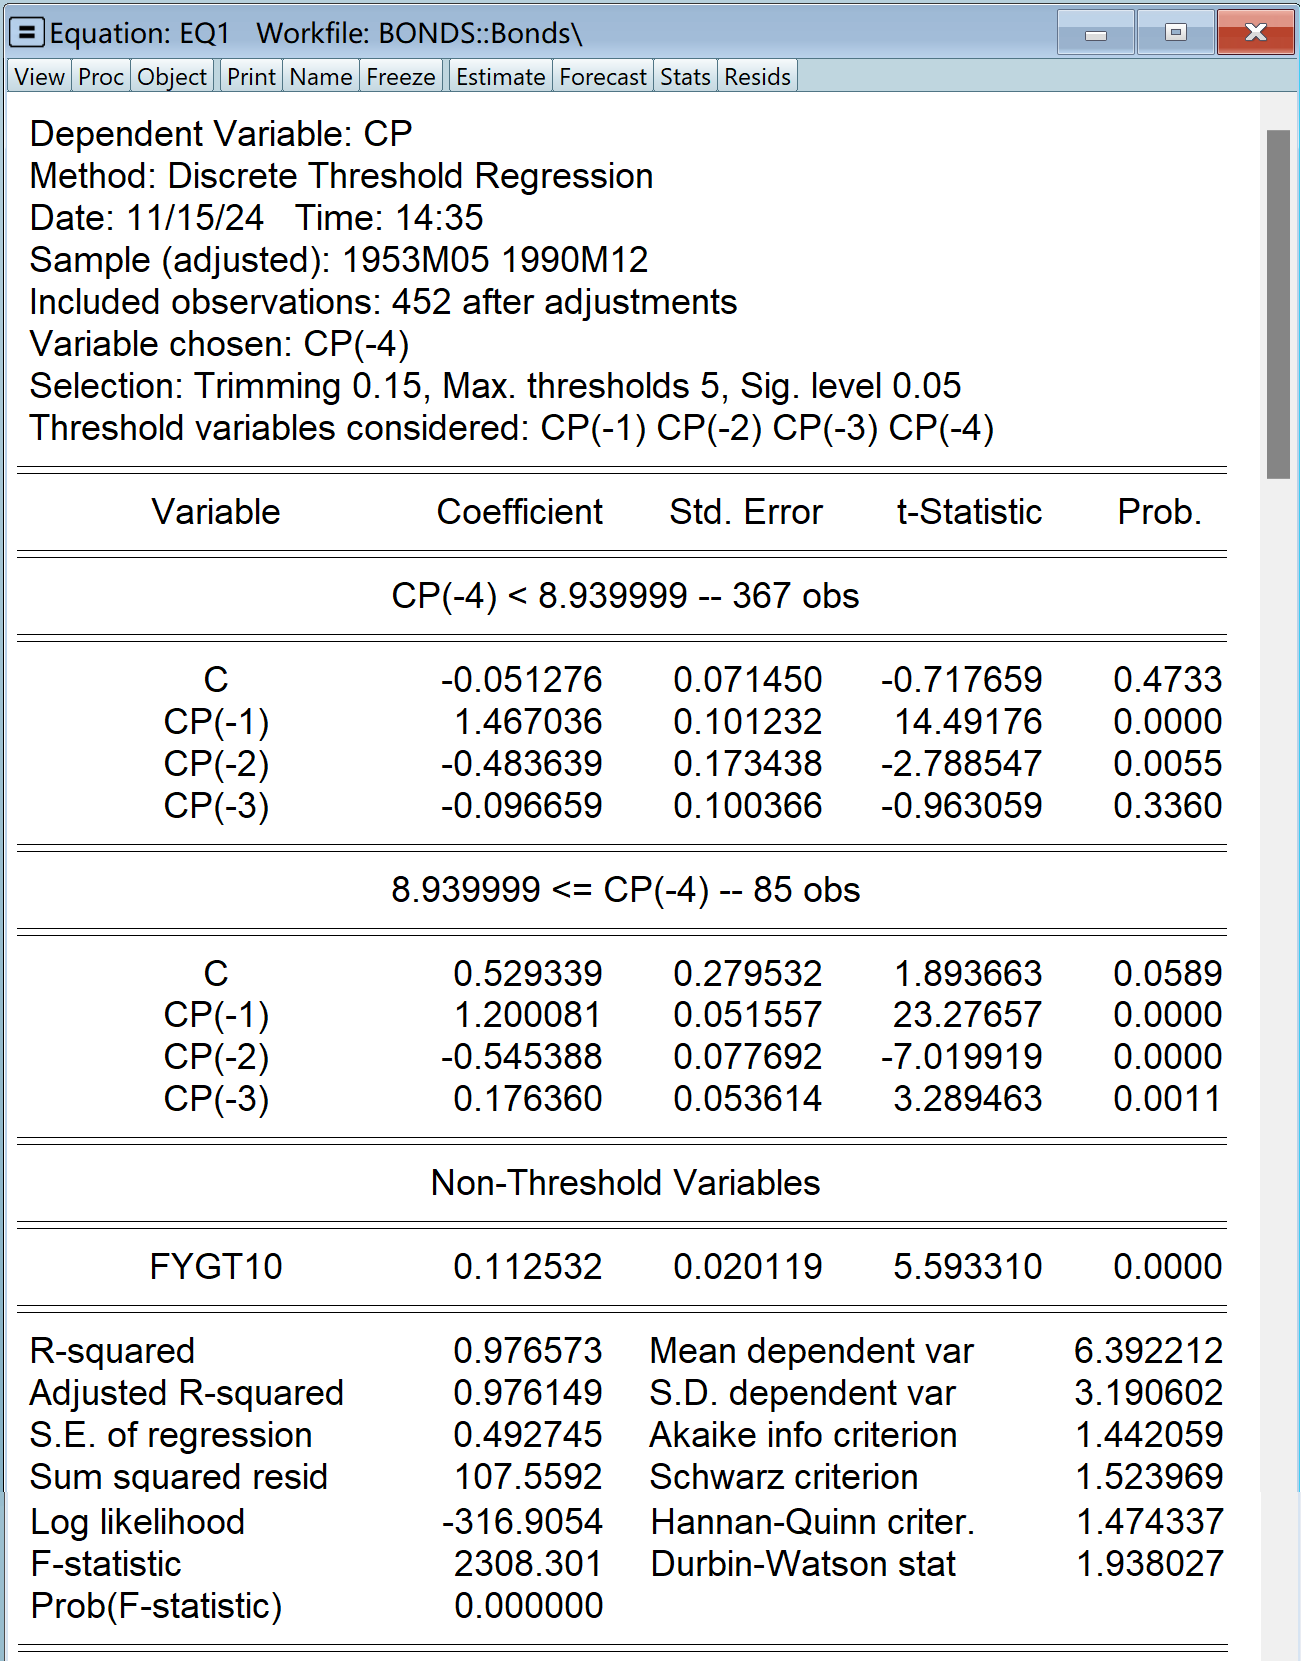
可以看到,“Variable chosen”显示最优的阈值变量是\(cp_{t-4}\)。此外,EViews自动检验后选择的阈值参数个数是1,其估计值为8.939999。如果需要自行设定阈值参数的个数,可以在threshold命令后加上“(method=fixedglob,nbreaks=2)”,前一个参数控制确定\(m\)的方法,后一个参数设\(m=2\)。
命令复习
(.)threshold:估计离散阈值回归模型
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 对上面为cp建立的离散阈值回归,如果把阈值变量改为fybaac的0到3阶滞后,最优的阈值变量是哪个?阈值参数的个数是多少?
MIDAS回归模型
MIDAS(Mixed Data Sampling,混合数据采样)回归是一类时间序列回归模型,它允许在模型的右侧放入更高频率的采样数据。
在MIDAS回归模型出世之前,在回归模型中融入更高频率数据的方式有两种。一种是把高频数据合成低频变量,然后再放入回归模型中。例如,$$y_t = \beta_0 + \beta_1 x_t + \gamma (\frac{\sum_{i=0}^2 z_{t-i}^H}{3}) +u_t$$其中,\(y_t\)和\(x_t\)是季度变量,\(z_t^H\)是月度变量,\(\beta_0\)、\(\beta_1\)和\(\gamma\)是模型参数。这里的合成是把一个季度里对应的月度数据(\(z_t^H\):季度\(t\)最后一个月的\(z\);\(z_{t-1}^H\):季度\(t\)中间月份的\(z\);\(z_{t-2}^H\):季度\(t\)第一个月的\(z\))进行了等权重平均。当然,合成的方式完全可以采取别的形式。合成低频变量最大问题在于合成的主观性。通常,我们并不清楚一个高频变量如何降频才是合适的。
另一种使用高频数据的方式是直接把高频数据扔进回归中。例如,$$y_t = \beta_0 + \beta_1 x_t + \sum_{i=0}^2 \gamma_i z_{t-i}^H +u_t$$这种方式完全由数据驱动来寻找最优的合成方案(假设\(z_t^H\)和\(y_t\)是线性关系),即寻找最优的加权系数\(\gamma_i\)。从理论上讲,这种方式比主观合成低频变量的方式要好,但它的问题是模型参数会更多。如果备选的高频变量有很多,且高频变量比低频变量的采样频率高很多的话,模型中会含有大量的待估参数,在数据量不够充足的情况下,估计的将偏差会非常大。
MIDAS回归实际上是对上面两种传统方式的折中:既靠数据驱动寻找高频变量的最优加权系数,又加入了一定的主观加权结构以限制参数的个数。
U-MIDAS
MIDAS回归模型的一般表达为:$$y_t =x_t’ \beta+ \sum_{i=0}^{k-1} \gamma_iz_{t-j-i}^H +u_t \tag{1}$$在这里,为了简化说明,我们假设只存在一个高频变量。在估计模型之前,我们需要先设定\(j\)和\(k\)这两个参数。前一个参数设定\(z_t\)从哪一期开始影响\(t\)期的\(y\);后一个参数设定高频变量的最大滞后阶数(注意:这一参数和低频变量及高频变量的采样频率无关)。如果我们不对加权系数\(\gamma_i\)做任何约束,这实际就是一个普通的多元线性回归,在EViews里被称为U-MIDAS(无约束MIDAS之意)。
估计MIDAS回归需要用到midas命令。打开EViews安装目录下的Example Files\EV13 Manual Data\Chapter 30 – MIDAS Regression\midas.wf1,你会发现workfile里有两个page:

其中,QuarterlyPage存放季度变量,MonthlyPage存放月度变量。
我们用季度变量realgdp对它的一阶滞后及月度变量emp建立一个U-MIDAS回归模型并估计,可以通过以下代码实现:
equation eq1
eq1.midas(fixedlag=5, midwgt=umidas) realgdp c realgdp(-1) @ monthlypage\emp(-1)括号中的参数fixedlag设定的是模型\((1)\)中的参数\(k\),参数midwgt设定的是MIDAS回归对高频变量加权的方式。括号后的表达和之前学过的多元回归估计差不多,只是需要在@后把高频变量列出来,包括设好初始的滞后阶数,即模型\((1)\)中的参数\(j\)。上述代码的估计结果为:

可以看到,这个输出结果和多元线性回归的输出结果本质上没有什么差别。
对存在多个高频变量的情形,实现MIDAS回归估计的代码也是类似的。例如,假设还存在一个SemiMonthlyPage的页面(存放每半月采样一次的变量),其中有一个变量m,那么,将其加入到上述模型(设其\(k=8\)、\(j=6\))可以使用如下代码:
eq1.midas(fixedlag=5 8, midwgt=umidas) realgdp c realgdp(-1) @ monthlypage\emp(-1) semimonthlypage\x(-6)阶梯加权
当数据量够多、参数不那么多时,使用U-MIDAS是可行的也是更优的,否则,我们需要对\(\gamma_i\)做约束以缩减参数的个数。阶梯加权(step weighting)是这样一种约束方式:$$\gamma_i = \theta_s \text{ for } s = \text{int}(i/L)$$其中,\(\text{int}(i/L)\)表示\(i/L\)的整数部分,\(L\)是一个需要事先设定的取值为正整数的步长(step length)参数。例如,当\(L\)设为2时,\(\gamma_0 = \gamma_1= \theta_0\)、\(\gamma_2 = \gamma_3= \theta_1\)、…这就把无约束情况下加权系数的个数缩减了一半。
采用阶梯加权只需令midwgt=step,并通过参数steps来设置步长(缺省时steps=3)。
Almon加权
Almon加权也叫PDL (polynomial distributed lag,多项式分布滞后) 加权,它通过p阶多项式来约束\(\gamma_i\):$$\gamma_i =\sum_{s=1}^{p} \theta_s (i+1)^{s-1} $$其中,\(\theta_s\)是待估参数,\(p\)是需要事先设定好取值的参数。显然,只有\(p<k\)时,Almon加权才能起到缩减参数的作用。
如果midas命令后面不带midwgt参数,那么,EViews将采用Almon加权。多项式的阶数由参数polynomial设置(缺省时polynomial=4)。
指数Almon加权
指数Almon加权设\(\gamma_i\)为:$$\gamma_i =\lambda w_i= \lambda \frac{e^{\theta_1i+\theta_2i^2}}{\sum_{s=0}^{k-1}e^{\theta_1s+\theta_2s^2}} $$其中,\(\theta_1\)、\(\theta_2\)和\(\lambda\)是待估参数。\(\lambda\)又叫斜率(slope)参数,这是因为它正是合成变量\(\sum_{i=0}^{k-1} w_iz_{t-j-i}^H\)的系数。
采用阶梯加权只需设midwgt=expalmon。对指数Almon加权和下面的贝塔加权,我们还可以通过cov=white来获得异方差一致的标准误。
贝塔加权
贝塔加权对\(\gamma_i\)的约束为:$$\gamma_i =\lambda w_i = \lambda (\frac{{\omega_i}^{\theta_1-1}(1-{\omega_i})^{\theta_2-1}}{\sum_{s=0}^{k-1}{\omega_s}^{\theta_1-1}(1-{\omega_s})^{\theta_2-1}}+\theta_3) $$其中,\(\theta_1\)、\(\theta_2\)和\(\theta_3\)和\(\lambda\)是唯四需要估计的参数,\(\omega_i\)满足:$$\omega_i =
\begin{cases}
\delta & i=0 \\
i/(k-1) & i=1,\cdots,k-2 \\ 1-\delta & i=k-1
\end{cases}$$其中,\(\delta\)是一个很小的数(\(=2.22e^{-16}\))。
在EViews中,令midwgt=beta会使用贝塔加权。在使用贝塔加权的情况下,我们可以通过参数beta进一步做三种参数约束:beta=shape对应\(\theta_1 = 1\);beta=endpoint对应\(\theta_3 =0\);beta=both对应\(\theta_1 = 1\)且\(\theta_3 =0\)。第一种约束会使\(w_i\)的形状(shape)受\(\theta_2\)控制,如果\(\theta_2>1\),\(w_i\)会缓慢减小,如果\(\theta_2<1\),\(w_i\)会缓慢增大。第二种约束会使\(w_i\)的两个端点(endpoint)\(w_0\)和\(w_{k-1}\)会极度接近0。第三种约束兼具前两种效果。
命令复习
(.)midas:估计MIDAS回归模型
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 基于上文中估计U-MIDAS回归的代码,估计一个基于Almon加权的MIDAS回归模型。如果多项式阶数设为5,你会发现高频变量的系数正好等于U-MIDAS回归的估计结果,这是为什么?
- 对阶梯加权和Almon加权,我们可以不设定fixedlag参数,而是设定一个maxlag参数,让EViews自动选择最优的\(k\)(寻找残差平方和最小的\(k\))。对多项式阶数为5的Almon加权,设maxlag=18,最优的\(k\)是多是?
SVAR模型
前面介绍的VAR模型,也叫简约式(reduced-form)VAR模型,这是一个相对SVAR(结构VAR,structural VAR)模型的概念。VAR模型应用的一个困难在于,我们往往不太清楚以什么样的次序排列内生变量,进而获得正交化误差才是合适的。最致命的是,当内生变量较多时,不同排序得出的分析结论可能会相差很大😢。为了解决这一问题,一种途径是使用SVAR模型,从源头上把正交化误差,也叫结构性新息(structural innovation)或结构性冲击(structural shock),给识别出来。
SVAR模型认为简约式VAR模型的误差之所以会存在相关,是因为内生变量间存在同期反馈效应(contemporaneous feedback effect),即同一时期的内生变量间可能会相互影响。因此,SVAR模型的一个基本设定是:$$Ay_t = c + \sum_{i=1}^p A_i^s y_{t-i} + Be_t \tag{1}$$其中,\(A\)和\(A_i^s\)是系数矩阵,其中的系数被称为结构系数(structural coefficients);\(e_t\)是满足\(Var(e_t)=I_k\)的结构冲击向量。系数矩阵\(A\)的存在是SVAR模型区别于VAR模型的关键。
由于SVAR模型存在同期反馈效应,这使得这一模型具有内生性问题,所以,估计SVAR模型的一种方法是利用工具变量。但是,实际应用中通常不会这么做,这是因为如果我们能利用经济学理论对结构系数进行约束的话,利用简约式VAR的估计结果就能把结构系数识别并估计出来,而不用再去寻找工具变量(寻找好的工具变量常常是件痛苦的事情😢)。常见的约束有三类:A-B约束、S约束和F约束。
A-B约束
对模型\((1)\)中的SVAR模型,我们可以利用\(A\)的逆得到模型的简约式表达:$$y_t = c + \sum_{i=1}^p A_i y_{t-i} + u_t \tag{2}$$其中,\(A_i = A^{-1} A_i^s\),\(u_t = A^{-1} Be_t \)。所以,简约式VAR模型里的误差方差矩阵为:$$Var(u_t) = \Sigma_u = A^{-1} BB’A’^{-1}$$
基于模型\((2)\),我们可以获得\(\Sigma_u\)的估计。由于方差矩阵是对称的,所以,这里面包含了对\(k(k+1)/2\)个参数的估计。因为\(A\)和\(B\)共有\(2k^2\)个参数,所以,不对\(A\)和\(B\)进行约束的话,是无法通过估计\(k(k+1)/2\)个参数,进而间接估计出\(A\)和\(B\)的。我们至少需要施加\(2k^2 – k(k+1)/2 = k^2+k(k-1)/2\)个约束才有可能对\(A\)和\(B\)进行识别。
通常,对矩阵\(B\),我们会设其非对角线上的元素都为0(共\(k^2-k\)个约束);对矩阵\(A\),我们会设其对角线全为1(共\(k\)个约束)。因此,我们至少还需对\(A\)的非对角元素再施加\(k(k-1)/2\)个约束。以[VAR模型]里的二元VAR模型为例,我们可以采用如下设定:$$A = \begin{bmatrix} 1 & 0\\ A_{21} & 1 \ \end{bmatrix}$$这意味着同期的dlinc不会进入dlcs的方程。
要估计上述设定的SVAR模型,我们需要先估计对应的简约式VAR模型,再通过设置约束来估计结构系数,相应的代码为:
var_a.cleartext(svar)
var_a.append(svar) @unitlower(A)
var_a.append(svar) @diag(B)
var_a.svar上面的第一行代码使用cleartext命令(加参数svar)清除已有的SVAR约束设置。第二、三行代码使用append命令(加参数svar)对SVAR进行约束设置:@unitlower函数把\(A\)设为对角线为1(unit的含义)的下三角(lower的含义)矩阵;@diag把\(B\)设为对角矩阵。最后一行代码通过svar命令实施估计。估计结果如下图所示:

图中最上面的部分需要注意收敛是否达成,这是因为SVAR模型的估计方法是MLE,使用了最优化算法。”Structural VAR is just-identified“表明当前的模型是正好识别的,如果存在过度识别,下面的结果会报告检验过度识别的LR统计量。接下来,是展示矩阵\(A\)和\(B\)的约束的部分。然后,是系数的估计结果(包括了估计值、标准误、z统计量和相应检验显著性的p值)以及对数似然值。最后,是矩阵\(A\)和\(B\)以及另外两个矩阵\(S\)和\(F\)(含义见下文)的估计结果。
S约束
如果把\(A^{-1}B\)看作一个整体,令\(S=A^{-1}B\),有:$$Var(u_t) = \Sigma_u = SS’^{-1}$$在这种设定下可以直接对\(S\)进行约束。由于\(S\)中只有\(k^2\)个参数,因此,一般只需施加\(k(k-1)/2\)个约束就能识别出结构冲击。当然,如果不对\(A\)和\(B\)做设定的话,我们通常无法经由估计\(S\),进而估计出\(A\)和\(B\)。
接上面的二元VAR例子,在EViews中,如果我们直接对\(S\)矩阵施加约束,至少得施加1个约束。如果我们打算把\(S\)设为上三角矩阵,可以使用@upper函数,代码如下:
var_a.cleartext(svar)
var_a.append(svar) @upper(S)
var_a.svar
对于这个例子,由于对矩阵\(A\)和\(B\)没有做任何设定,所以,在输出的结果中不会出现它们的估计结果。
F约束
上面介绍的A-B约束和S约束都是所谓的短期(short-run)约束,即约束会直接影响结构冲击的短期作用。事实上,为了识别SVAR模型,我们也可以实施长期(long-run)约束,该约束是直接施加在累积响应(系数)上的。
模型\((2)\)可以表达为:$$y_t = \Psi(1)^{-1}c + \Psi(L)^{-1}Se_t $$其中,\(\Psi(L)\)为滞后算子多项式:$$ \Psi(L) = I_k – A_1L – \cdots – A_pL^p$$所以,累计响应(系数)就是\(\Psi(1)^{-1}S\),这就是EViews中的\(F\)矩阵,F约束即是对它的约束。同S约束一样,为了识别SVAR模型,F约束一般需要至少\(k(k-1)/2\)个。下面是一个施加F约束的例子:
var_a.cleartext(svar)
var_a.append(svar) @F(1,2) =  @F(2,1)
var_a.append(svar) @F(1,1) =  1
var_a.svar
中间的两行代码直接对\(F\)矩阵的元素做了约束:令\(F\)的两个非对角元素相等,并令\(F\)的第一个对角元素等于1。由于我们其实只需要施加1个约束就能识别二元SVAR模型,所以,这是一个过度识别的例子。
约束设置
除了上面介绍过的施加约束的方式外,我们还可以利用以下函数:
@vec(X) = v1, v2 …:该函数对矩阵X按列设定,例如,@vec(A) = 1 0, na 1(此处的na表示对参数不做约束),这等价于@unitupper(A)@row(X,r) = a:该函数把X的r行的值全设为a@col(X,c) = a:该函数把X的c列的值全设为a
当然,我们也可以采用鼠标模式来设置约束:估计完简约式VAR模型后,点击var对象窗口左上方的Proc/Estimate Structural Factorizaton…,将会出现下图:

图中的Restriction Preset处可以选择一些常用的约束设置;Restrictions处可以用鼠标选中不同的矩阵,然后通过右侧Manual下的框进行手动设置。注意,在EViews中允许同时对4个矩阵进行约束设置,尽管我们一般不会这么做。
冲击响应和方差分解
估计完SVAR模型后,可以利用前面见过的impulse和vdcomp命令来获得冲击响应图和方差分解结果,只是需要注意要把参数imp设定为struct:
var_a.impulse(imp=struct)
var_a.vdcomp(imp=struct)
命令复习
.cleartex(svar):清空SVAR模型的约束设置.(svar):对SVAR模型进行约束设置append.svar:输出SVAR模型的估计结果
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 通过
@vec函数重现上述施加S约束的估计结果。 - 对上面的施加F约束的例子,过度识别检验的结果显示约束设置是否合理?
冲击响应函数
VAR模型除了可以用来预测,也可以用来研究VAR系统中一个变量的冲击如何在系统中进行传导,进而影响模型的内生变量。一个变量的冲击,指的是以该变量为因变量的方程的误差的意外变化。
冲击响应函数
冲击响应函数(IRF,Impulse Response Functions)描述VAR系统中某一变量的冲击如何影响内生变量的未来值。以由dlcs和dlinc构建的VAR(2)模型为例:$$ x_t = dlcs_t, z_t = dlinc_t,$$ $$ \begin{bmatrix}x_{t} \\ z_{t} \ \end{bmatrix} = \begin{bmatrix}c_{1} \\ c_{2} \ \end{bmatrix} + \sum_{i=1}^2 \begin{bmatrix}A_{i11} & A_{i12}\\ A_{i21} & A_{i22} \ \end{bmatrix} \begin{bmatrix}x_{t-i} \\ z_{t-i} \ \end{bmatrix} + \begin{bmatrix}u_{1t} \\ u_{2t} \\ \end{bmatrix} \tag{1}$$ 该模型的冲击响应函数为:当变量处于VAR模型决定的期望值(稳态)、误差等于0且其他条件保持不变时,\(u_{1t}\)变化对\(\{x_{t+i}\}_{i=1}^{\infty}\)的影响,\(u_{1t}\)变化对\(\{z_{t+i}\}_{i=1}^{\infty}\)的影响,\(u_{2t}\)变化对\(\{x_{t+i}\}_{i=1}^{\infty}\)的影响和\(u_{2t}\)变化对\(\{z_{t+i}\}_{i=1}^{\infty}\)的影响。\(u_{1t}\)的变化被称为\(x_{t}\)的冲击,\(u_{2t}\)的变化被称为\(z_{t}\)的冲击。由冲击引起的\(x_{t}\)和\(z_{t}\)的变化被称为响应。
一般情况下,冲击的大小(即误差的变化量)会取为误差的一个标准差。此外,由于误差间常常是相关的:\(cov(u_{1t},u_{2t})\neq 0\),\(u_{1t}\)的变化会导致\(u_{2t}\)变化,即“其他条件保持不变”无法达成。因此,我们一般不直接考虑模型\((1)\)中误差的变化,而是先利用误差的协方差矩阵的Cholesky分解将误差正交化,然后再考虑正交化误差(它们互不相关)的变化。所以,一般情况下讲的冲击,是对正交化误差而言的。
估计完一个VAR模型后,要获得IRF可以点击var对象窗口上的Impulse,点击后会弹出如下窗口:
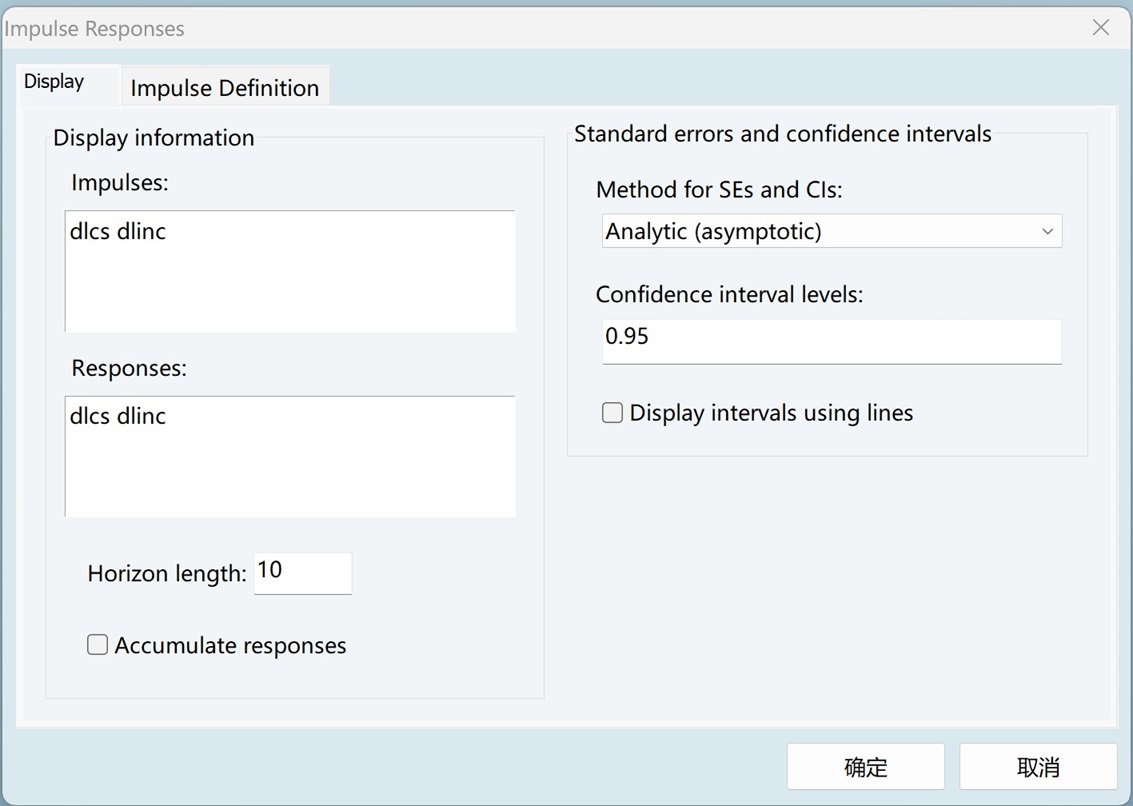
其中,Impulses下设置要查看哪些变量的冲击。Responses下设置要考虑哪些变量的响应。Horizon length设置显示多少期冲击的影响。Accumulated Responses如果勾选的话,会显示冲击的累积效应。Methods for SEs and CIs设置要不要显示响应的置信区间,以及如果显示的话用哪种标准误(默认如图所示)。Confidence interval levels设置置信区间的置信水平,默认为0.95。在这个窗口选Impulse Defination会切换到如下窗口:
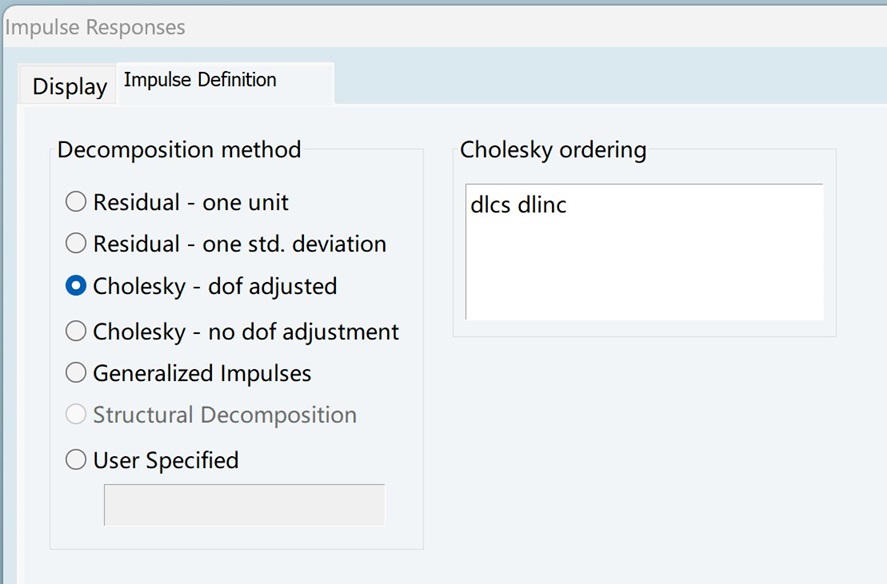
其中,Decomposition Method设置使用什么样的冲击。EViews默认选Cholesky – dof adjusted,设置冲击为正交化残差一个标准差(也是一单位)的变化,它与选Cholesky – no dof adjustment的区别在于二者计算残差协方差矩阵时后者没有进行自由度调整。Residual – one unit和Residul – one std.deviation表示冲击是原始残差一单位和一个标准差的变化。注意,这四个选项都要求在右侧的Cholesky Ordering下设置内生变量的排序,不同的排序会得到不一样的IRF,默认的排序为估计VAR模型时ls命令后内生变量的排序。Generalized Impulses是一个不一样的选项,选它将输出广义的IRF,它不依赖正交化残差,因此与内生变量的排序无关。设置好一切后,点击确定就能得到IRF。
下面我们看看在键盘模式下如何获得IRF。我们可以使用impulse命令:
var_a.ls 1 2 dlcs dlinc @restrict @l1(1,2) = 0, @l2(1,2)=0
var_a.impulse(se=a)其中,参数se用于设置响应的标准误的算法,代码中用的是EViews的默认设置。如果没有用这个参数,冲击响应图里不会显示响应的置信区间(下图中阴影部分)。代码执行的结果如下:
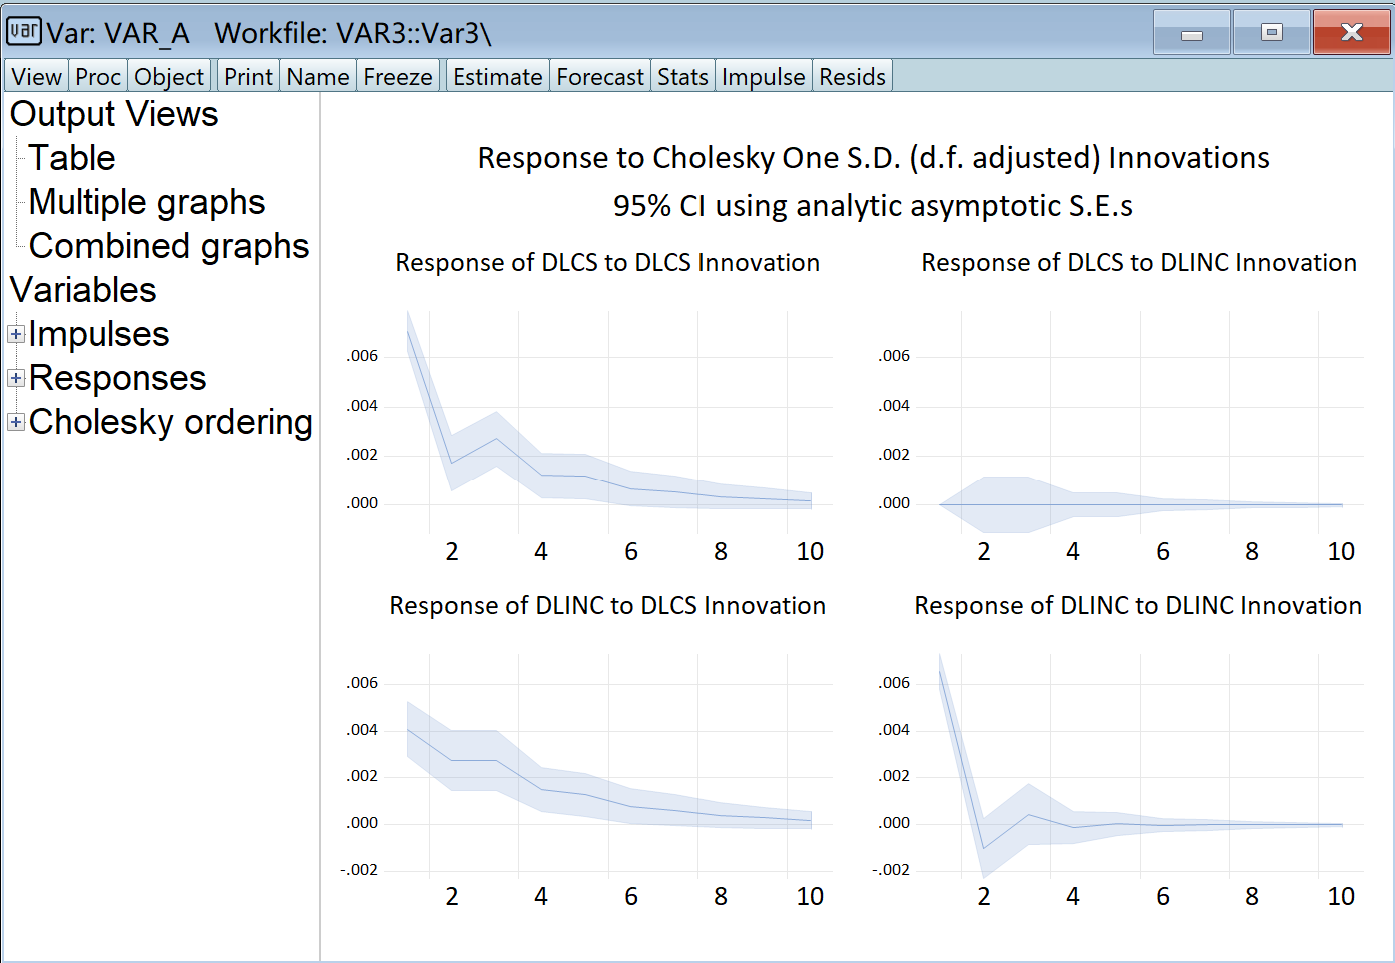
图中右侧的图是冲击响应图,两种冲击,两个内生变量,正好四张子图。图中的纵轴表示变量偏离其稳态的值。可以看到,冲击离0期越远,影响越小。此外,一个变量的冲击对它自身的影响一般比对其他变量的影响大。在图的左侧可以进行一些手动的调节,例如,把一个响应对所有的冲击放入同一张图,你可以自行探索一下。
如果我们只关心某些变量的响应,可以在impulse后直接跟上相应的变量,例如,
var_a.impulse(se=a) dlcs如果只关心某些冲击带来的影响,可以加上@imp,然后跟上相应冲击对应的变量,例如,
var_a.impulse(se=a) dlcs @imp dlinc如果想要改变默认的内生变量排序,可以利用@order,例如,
var_a.impulse(se=a) dlcs @imp dlinc @order dlinc dlcsimpulse命令有一系列可选参数可用。如果我们想要以数值方式显示IRF,可以这样:
var_a.impulse(se=a,t) 't,table之意如果想要显示冲击的累积效应,可以这样:
var_a.impulse(se=a,a) 'a,accumulated之意如果想要显示广义的IRF,可以这样:
var_a.impulse(se=a,imp=gen) 上面的例子是最常用到的可选参数设置,如果你想学习更多的可选参数及其相应的设置,你可以通过鼠标模式,利用捕获窗口进行进一步的探索。
方差分解
方差分解(variance decomposition)指的是将VAR模型的预测误差的方差进行分解,利用它可以看出预测误差的方差主要是由哪些变量的冲击导致的。实施方差分解可以选var对象窗口左上的View/Variance Decomposition,点击后会弹出如下窗口:

其中,Display Information下设置要进行方差分解的内生变量。Periods设置最多显示几步向前预测的方差分解。Factorization下默认(也只能)选Cholesky分解,这是因为和计算冲击响应函数一样,方差分解也需要使用Cholesky分解(为了保证方差的可加性),这也意味着进行方差分解也要设定内生变量的排序,在Cholesky ordering处设置。右侧设定标准误及置信区间的计算方法,默认是用Monte Carlo重抽样的方式计算,抽样次数为100次。0.95是默认的置信水平。
实施方差分解的命令是vdecomp,它的用法和impulse非常像,请看下面的例子:
var_a.vdecomp(t) dlinc @order dlinc dlcs代码中,vdecomp后直接跟要进行方差分解的内生变量(此处仅考虑dlinc),@order后设置内生变量的排序,参数t指方差分解将以数值表的形式展示代码,执行的结果如下:
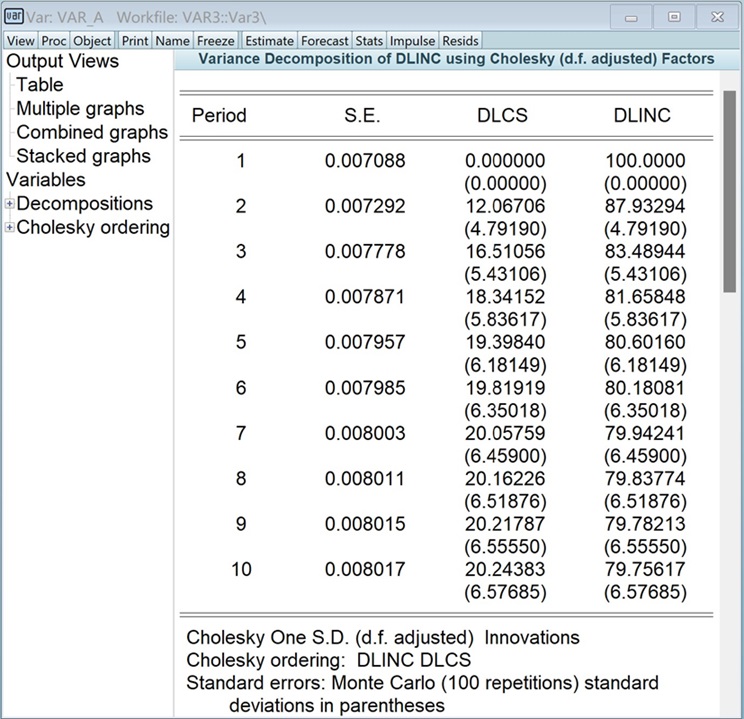
可以看到,对dlinc的一步向前预测,预测误差的方差100%来源于dlinc的冲击;对dlinc的两步向前预测,预测误差的方差有12.06706%来源于dlcs的冲击,有87.93294%来源于dlinc的冲击,…括号里的数值是对应的标准误。
以Stacked graphs的形式展示方差分解结果是比数值表更直观的方式,在EViews 13里,可以通过为vdecomp加上可选参数sg得到Stacked graphs,结果如下图所示:
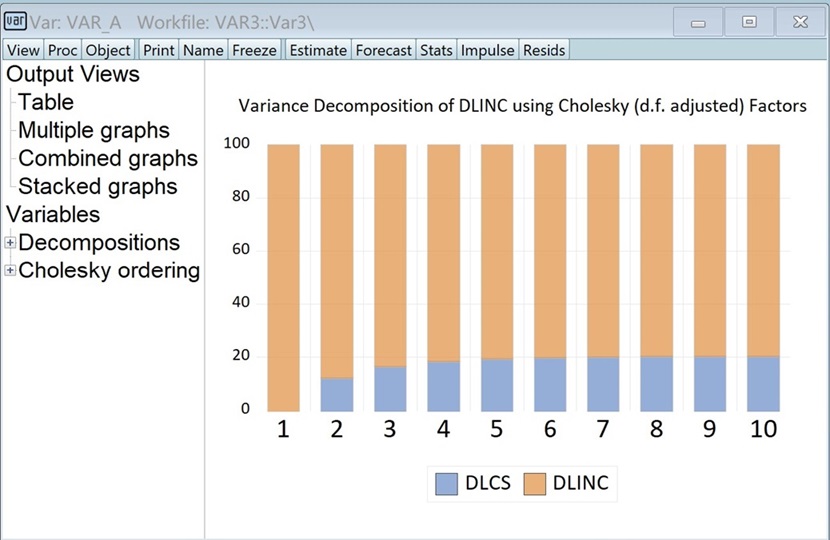
图中,不同高度不同颜色的竖条代表不同冲击对方差的贡献度。
历史分解
冲击响应和方差分解都是在看冲击带来的”平均“影响。如果我们关注一个特定的(样本内的)历史时段,好奇在那一时段内某一变量的演化主要是由哪些冲击主导的,那么我们可以利用历史分解(historical decomposition)。简单来说,历史分解就是基于已实现的历史数据,把每一个变量分解成不同冲击影响的部分的加和,外加一个近似误差。在EViews,进行历史分解的命令是hdecomp:
var_a.hdecomp 结果如下图所示:

图中的Total stochastic是两部分冲击影响的加和,绿色的线就是不同冲击影响的部分。可以看到,在全时段内,dlcs的演化基本由dlcs的冲击主导。在某些时段(如75-80年),dlinc的演化由dlcs的冲击主导;在另一些时段内(如93-95年),dlinc的演化由dlinc的冲击主导。如果我们只想看或展示某一时段的历史分解,如75Q1-80Q1,我们可以这样使用hdecomp命令:
var_a.hdecomp(start=1975q1, end=1980q1)在应用历史分解时,一个需注意的点是我们尽量不要分析样本早期的时段,因为那部分的近似误差一般会较大。
命令复习
.impulse:输出VAR模型的冲击响应函数.vdecomp:输出VAR模型的方差分解结果.hdecomp:输出VAR模型的历史分解结果
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作并以Stacked Graphs的形式输出模型的方差分解结果。
- 输入代码var_a.hdecomp dlinc,看一看对dlinc,是否还存在其他某些时段,在其中某一冲击起到了明显的主导作用。
格兰杰因果检验
预测一个变量可以利用它自身的历史数据,也可以利用其他变量的历史数据,这是构建VAR模型的动因。估计完一个VAR模型后,一个自然的问题是,其他变量是否真包含了有助于改进目标变量预测精度的信息?要回答这一问题,我们可以使用格兰杰因果(Granger causality)检验。
格兰杰因果检验
仍以由dlcs和dlinc构建的VAR(2)模型为例:$$ x_t = dlcs_t, z_t = dlinc_t,$$ $$ \begin{bmatrix}x_{t} \\ z_{t} \ \end{bmatrix} = \begin{bmatrix}c_{1} \\ c_{2} \ \end{bmatrix} + \sum_{i=1}^2 \begin{bmatrix}A_{i11} & A_{i12}\\ A_{i21} & A_{i22} \ \end{bmatrix} \begin{bmatrix}x_{t-i} \\ z_{t-i} \ \end{bmatrix} + \begin{bmatrix}u_{1t} \\ u_{2t} \\ \end{bmatrix} \tag{1}$$ 在模型中,如果\(A_{112}\)和\(A_{212}\)不同时为零,则dlinc的滞后项会进入以dlcs为因变量的方程。在这种情况下,相对基于dlcs的AR(2)模型的预测,我们可以说dlinc的滞后项含有改进预测dlcs的信息,此时,我们称dlinc是dlcs的格兰杰原因。同理,如果\(A_{121}\)和\(A_{221}\)不同时为零,我们称dlcs是dlinc的格兰杰原因。格兰杰因果检验实际上就是检验$$A_{112}=A_{212}=0$$ 或 $$A_{121}=A_{221}=0$$ 在一个VAR模型中,要检验一个变量\(x\)是否是另一个变量\(z\)的格兰杰原因,事实上就是对以\(z\)为因变量的方程检验所有\(x\)的滞后项的系数全为0。
如上所述,格兰杰因果并不是通常意义下我们理解的原因和结果,而是一种与预测改进相关的概念,在实际应用中,这个概念经常被误解。
在EViews中,进行格兰杰因果检验可以在估计完模型后,选var对象窗口左上角的View/Lag Structure/Granger Causality/Block Exogeneity Tests,或利用testexog命令:
var_a.testexog代码执行的结果如下:
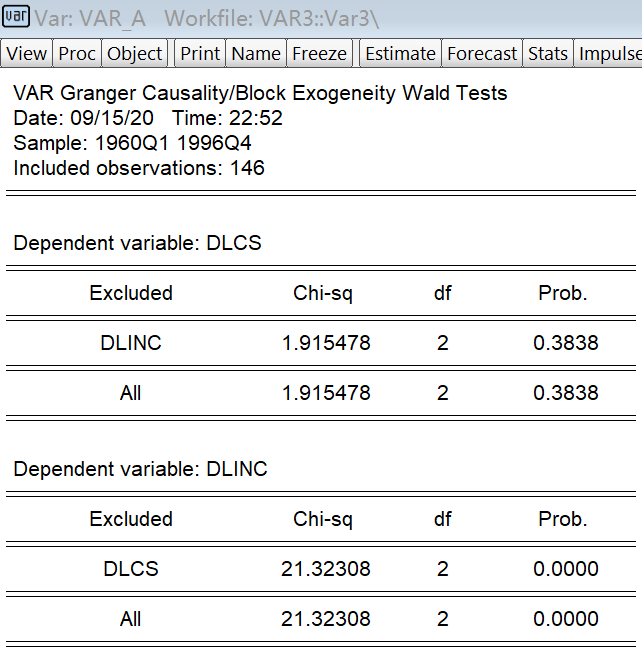
表中的Dependent variable标明了实施格兰杰因果检验的方程,例如,Dependent variable: DLCS表示检验是针对因变量为dlcs的方程实施的。Excluded下的DLINC对应检验dlinc的滞后项系数全为0,即检验dlinc不是dlcs的格兰杰原因。Excluded下的ALL对应检验除因变量外,方程中所有其他变量的滞后项系数全为0。由于当前的VAR模型只含两个变量,所以,DLINC和ALL对应的检验结果是相同的。Chi-sq一列报告了检验统计量的值。检验统计量渐近服从卡方分布,df一列报告了对应的自由度。Prob.一列报告了检验的p值。表中的结果显示,dlinc不是dlcs的格兰杰原因,但dlcs是dlinc的格兰杰原因。
滞后排除检验
对VAR模型,另一个常用的检验是滞后排除(lag exclusion)检验,即检验某阶滞后项的系数是否全为0。例如,对模型\((1)\),检验\(A_{111}=A_{112}=0\)就是因变量为dlcs的方程的一阶滞后排除检验;检验\(A_{221}=A_{222}=0\)就是因变量为dlinc的方程的二阶滞后排除检验;检验\(A_1=0\)就是整个模型的一阶滞后排除检验。
实施滞后排除检验,可以在估计完模型后选var对象窗口左上角的View/Lag Structure/Granger Causality/Lag Exclusion Tests,或利用testlags命令:
var_a.testlags代码执行的结果如下:
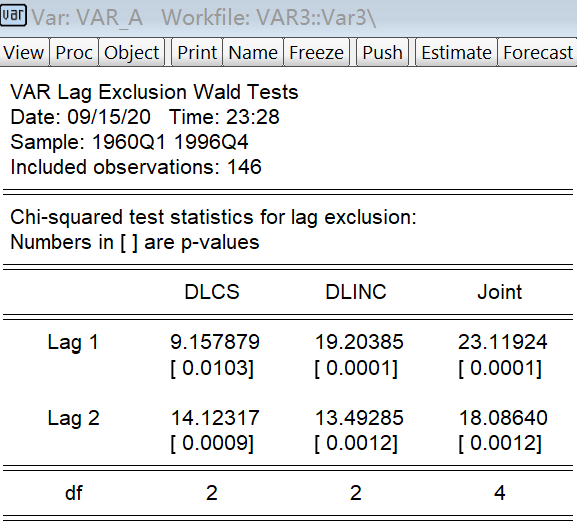
表中的DLCS和DLINC两列是两个单方程的滞后排除检验结果,Joint一列是整个模型的滞后排除检验结果。Lag 1和Lag 2分别对应一、二阶滞后排除检验。方括号上的数是检验统计量的值,方括号里的数是对应的p值。Joint检验也可以用来确定VAR(p)模型的滞后阶数p。
带约束的模型
利用格兰杰因果检验或滞后排除检验,我们可能会发现VAR模型中的某些系数是不显著的,因此,可以考虑把相应的滞后项从模型中拿掉,这相当于把系数约束为0。有些时候,我们也可以根据经济或金融理论对系数施加约束。对VAR模型的系数进行约束可以减少模型中未知参数的个数,如果约束施加得当,模型的估计偏差会减轻,预测精度会提升。
估计带约束的VAR模型,我们可以在估计VAR模型的窗口选VAR Restricitons,界面如下图所示:
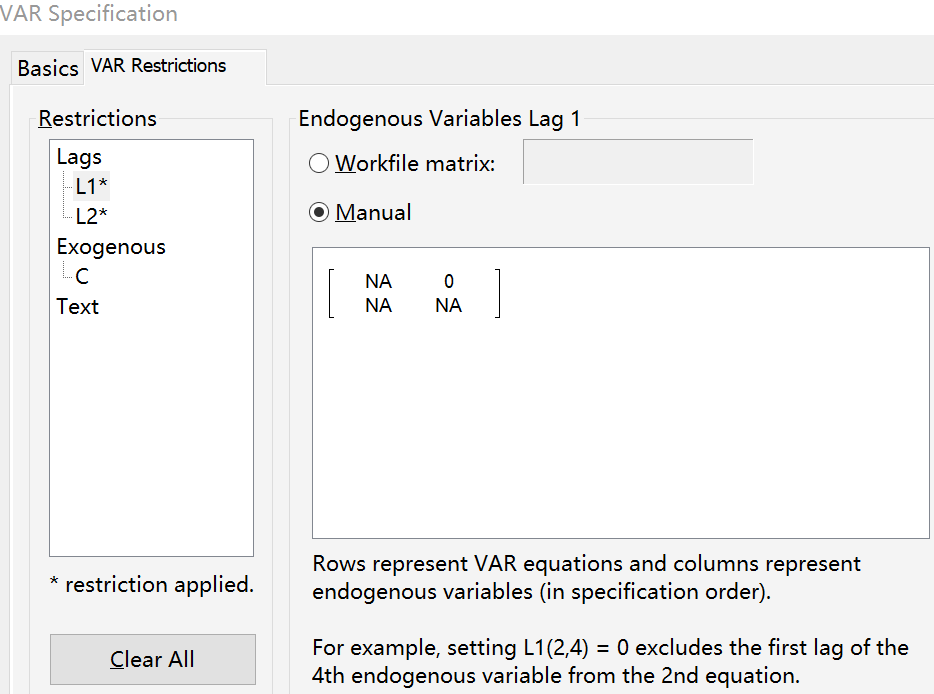
左侧的Lags指对应的系数矩阵,C指截距。右侧的Manual下,我们可以手动对系数进行约束,例如,要把某系数设为0,只需找到对应系数矩阵中的对应元素,然后将NA改为0(NA表示不对系数做约束)。约束设好后,点确定就能估计了。对带约束的情形,EViews会使用更有效的GLS估计模型。
利用代码估计带约束的模型要复杂一些,请看下面的例子。对模型\((1)\),格兰杰因果检验已经发现dlinc不是dlcs的格兰杰原因,因此,可以考虑设\(A_{112}=A_{212}=0\),这可以通过如下代码实现:
var_a.ls 1 2 dlcs dlinc @restrict @l1(1,2) = 0, @l2(1,2)=0代码中,@restrict声明实施约束,后面的@l1(1,2)=0表示将一阶滞后项的系数矩阵的(1,2)元素设为0,@l2(1,2)=0同理。代码执行的结果如下:
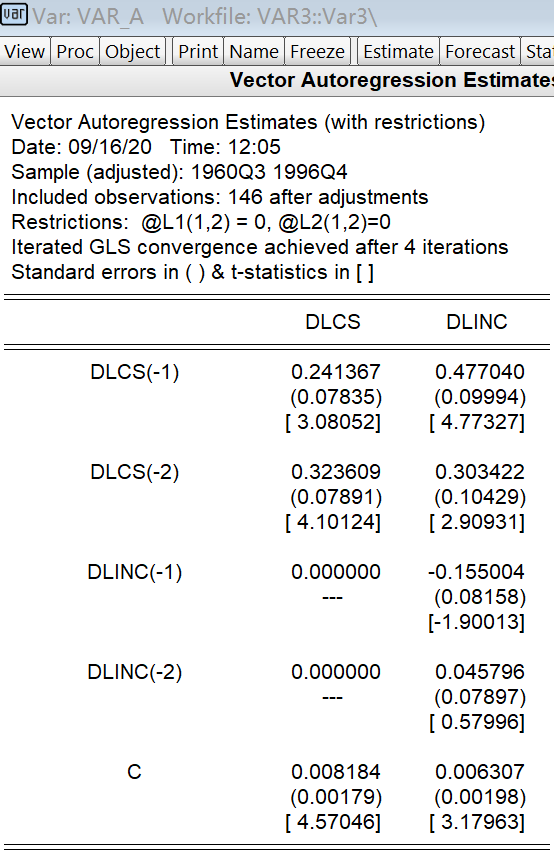
如表所示,在以dlcs为因变量的方程中,dlinc的滞后项的系数都被约束为0了。
预测
VAR模型设定好估计完后,就可以实施预测了,动态预测仍用forecast命令,静态预测仍用fit命令。利用VAR模型会同时预测多个变量,所以报告的结果会比应用ARMA或ARIMA模型的情形稍微复杂一点。由于基于VAR模型的预测本质上和基于AR模型的预测没什么区别,因此,我就不赘述了,你可以点var对象窗口上的Forecast自行探索一下。
命令复习
.testexog:实施格兰杰因果检验.testlags:实施滞后排除检验.forecast:基于VAR模型实施动态预测.fit:基于VAR模型实施静态预测
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作并利用建立的VAR模型预测1997Q1的dlcs和dlinc。
北京 海淀
13.9℃ 
博文+教程
阅读
市场行情
- 上证指数
- 深证成指
- 创业板指
- 国债指数