离散因变量模型
当我们研究因变量\(y_i\)会受那些因素影响,且\(y_i\)取值为离散值时,回归模型一般来说不是一个合适的分析模型。譬如,如果\(y_i\)要么取值为1,要么取值为0,那么,我们估计下面这么一个模型$$y_i = \beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i} + u_i$$在技术上不存在任何困难,用最小二乘法就完事了。但是,这样的估计结果,在应用上会存在问题。
我们知道,在常规状态下,$$\hat{y}_i=\hat{\beta}_0 + \hat{\beta}_1 x_{1i} +\hat{\beta} x_{2i}$$是\(y_i\)的拟合值。但是,现在的\(y_i\)要么为1,要么为0,而\(\hat{y}_i\)几乎不可能正好取值到1或0,所以,把\(\hat{y}_i\)解释为\(y_i\)的拟合值是不合适的。事实上,更符合逻辑的解释是:\(\hat{y}_i\)是给定\(x_{1i}\)和\(x_{2i}\)的条件下,\(y_i\)取值为1的概率。这也是我们会把因变量取值为1或0的线性回归模型称为线性概率模型(linear probability model)的原因。
线性概率模型存在的最大问题是,我们无法保证所有被估计的概率\(\hat{y}_i\)都在\([0,1]\)之间,也无法保证如果我们想根据模型估计结果预测一组新的\(x_{1}\)和\(x_{2}\)对应的\(y=1\)的概率时,该概率也在\([0,1]\)之间。所以,回归模型并不是一个适合分析离散因变量的模型。
在计量经济学中,适合用来分析离散因变量的模型被统称为离散因变量模型(discrete dependent variable models),由于因变量的离散取值常常对应着人、公司、政府等单位的不同选择行为,因此,这类模型也常被称为离散选择模型(discrete choice models)。离散因变量模型根据因变量的取值特征,又可进一步分为二值因变量模型、多值因变量模型、排序因变量模型、计数模型等类型。
GARCH类模型
前面你已经学到了如何建立并估计一个GARCH模型,以及如何进行相应的诊断检验和预测等内容。接下来,我将介绍几个GARCH模型的衍生品,我把它们统称为GARCH类模型,由于它们的建模方式与GARCH模型差别不大,我将主要介绍如何用代码实现建模和估计。
ARCH-M模型
ARCH-M中的M,指的是Mean,均值方程之意。把\(\sigma_t^2\)或其某种函数形式当作一个解释变量放入均值方程中,就形成了一个ARCH-M模型。例如,$$r_t = \theta_0 + \theta_1r_{t-1} + \gamma f(\sigma_t^2) + u_t $$ $$\sigma_t^2 = \omega + \alpha u_{t-1}^2 + \beta \sigma_{t-1}^2 $$ 在EViews中,\(f(\sigma_t^2)\)可以设为\(\sigma_t\)、\(\sigma_t^2\)或\(\log(\sigma_t^2)\),它们对应arch命令的可选参数archm分别等于sd、var或log的情形,例如:
eq1.arch(archm=sd) dlog(spx) c ar(1)           '令波动率为解释变量
eq1.arch(archm=var) dlog(spx) c ar(1)          '令方程为解释变量
eq1.arch(archm=log) dlog(spx) c ar(1)          '令方程的对数为解释变量
IGARCH模型
IGARCH,Integrated GARCH之意。对GARCH(p,q)模型,如果约束其方差方程中的ARCH项和GARCH项的系数之和为1,且截距项为0,就得到了IGARCH(p,q)模型:$$\sigma_t^2 = \sum_{i=1}^p\alpha_i u_{t-i}^2 + \sum_{i=1}^q \beta_i \sigma_{t-i}^2 $$ $$\sum_{i=1}^p\alpha_i + \sum_{i=1}^q \beta_i =1 $$
建立并估计IGARCH模型,只需为arch命令加上可选参数integrated,例如:
eq1.arch(1,2,integrated) dlog(spx) c ar(1) 'IGARCH(1,2)TARCH模型
TARCH,Threshold ARCH之意。TARCH模型是基于ARCH模型的扩展,可以用来刻画波动率的杠杆效应。TARCH(p,r)模型的方差方程可以表达为:$$\sigma_t^2 = \omega + \sum_{i=1}^p\alpha_i u_{t-i}^2 + \sum_{i=1}^r \gamma_i u_{t-i}^2I_{t-i}^-$$其中,\(I_{t-i}^-\)是一个虚拟变量,当\(u_{t-i}<0\)时其值取1,否则取0。如果\(\gamma_i>0\),则波动率存在\(i\)阶杠杆效应。在TARCH(p,r)模型中加入GARCH项,可以将TARCH(p,r)模型扩展为TGARCH(p,q,r)模型:$$\sigma_t^2 = \omega + \sum_{i=1}^p\alpha_i u_{t-i}^2 + \sum_{i=1}^q \beta_i \sigma_{t-i}^2 + \sum_{i=1}^r \gamma_i u_{t-i}^2I_{t-i}^-$$
严格来讲,EViews中的TARCH模型并不是文献中的TARCH模型,而是文献中的GJR-GARCH模型,尽管二者很像。文献中的TARCH模型是直接对\(\sigma_t\)建模,而非对\(\sigma_t^2\)建模。
建立并估计TGARCH模型,只需利用arch命令的可选参数thrsh,例如:
eq1.arch(3,2,thrsh=1) dlog(spx) c ar(1) 'TGARCH(3,2,1)代码中,thrsh的作用是设置TGARCH(p,q,r)中的r。
EGARCH模型
EGARCH,Exponential GARCH之意。EGARCH(p,q,r)模型的方差方程可以表达为:$$\log(\sigma_t^2) = \omega + \sum_{i=1}^p\alpha_i |\frac{u_{t-i}}{\sigma_{t-i}}| + \sum_{i=1}^q \beta_i \log(\sigma_{t-i}^2) + \sum_{i=1}^r \gamma_i \frac{u_{t-i}}{\sigma_{t-i}}$$ 如果\(\gamma_i<0\),则波动率存在\(i\)阶杠杆效应。
建立并估计EGARCH模型,只需为arch命令加上可选参数egarch,例如:
eq1.arch(2,1,thrsh=2,egarch) dlog(spx) c ar(1) 'EGARCH(2,1,2)在有egarch存在的情况下,可选参数thrsh只起设置EGARCH(p,q,r)中r的作用。代码执行的结果如下图所示:

注意,表中方差方程的参数是由C(3)、C(4)…表示的,它们对应模型中的哪个参数要看红框部分的模型表达。
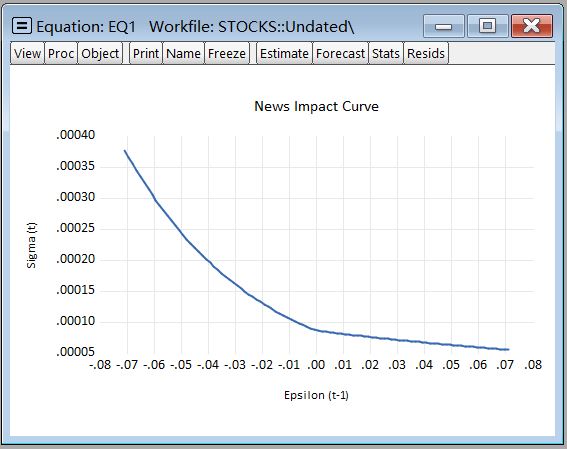
估计完能刻画杠杆效应的GARCH类模型,一个直观展示杠杆效应的工具是消息影响曲线(News Impact Curce),它显示当期的波动率如何受上期的误差影响。在EViews中,通过newsimpact命令可以得到模型的消息影响曲线:
eq1.newsimpact '展示模型的消息影响曲线结果如下:
PARCH模型
PARCH,Power ARCH之意。PARCH(p,q,r)模型的方差方程可以表达为:$$\sigma_t^{\delta} = \omega + \sum_{i=1}^p\alpha_i (|u_{t-i}|-\gamma_{i} u_{t-i})^{\delta} + \sum_{i=1}^q \beta_i \sigma_{t-i}^{\delta} $$ 其中,\(\delta >0\),\(|\gamma_i|\leq 1\),当\(i>r\)时有\(\gamma_{i}=0\),且\(r\leq p\)。如果\(\gamma_i<0\),则波动率存在\(i\)阶杠杆效应。
建立并估计PARCH模型,需为arch命令加上可选参数parch,例如:
eq1.arch(1,0,asy=1,parch) dlog(spx) c ar(1) 'PARCH(1,0,1)其中,可选参数asy用来设置PARCH(p,q,r)中的r。
如你所见,PARCH模型是一个高度非线性的模型,所以,对它很容易出现估计不收敛的情况。此外,和EGARCH模型一样,方差方程的参数在报告的表中也是由C(3)、C(4)…表示的。
命令复习
(.)arch(archm=值):建立ARCH-M模型并估计(.)arch(integrated):建立IGARCH模型并估计(.)arch(thrsh=值):建立TGARCH模型并估计(.)arch(egarch):建立EGARCH模型并估计(.)arch(parch):建立PARCH模型并估计.newsimpact:展示模型的消息影响曲线
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作。
- 利用dlog(spx)建立如下模型:均值方程是AR(0)模型;方差方程是EGARCH(1,1,1)模型;误差服从GED;方差方程中加入dlog(vix)的一阶滞后。估计该模型并回答问题:(a) dlog(vix)的一阶滞后是否显著;(b) 波动率是否存在显著的杠杆效应。
- 展示上面EGARCH(1,1,1)模型的消息影响曲线。
GARCH模型
GARCH(Generalized Autoregressive Conditional Heteroskedasticity)模型是金融领域内用得最多的非线性统计模型,它的一个主要应用是预测金融资产收益率的波动率(volatility),这对期权定价、风险管理等金融实务极为重要。当然,GARCH模型还有其他各种应用,有些应用甚至是在金融、经济领域之外的。
一个完整的GARCH模型包含均值方程(mean equation)和方差方程(variance equation)两部分,例如,$$y_t = \theta_0 + \theta_1x_{t} + u_t \tag{均值方程}$$ $$\sigma_t^2 = \omega + \alpha u_{t-1}^2 + \beta \sigma_{t-1}^2 \tag{方差方程}$$ 其中,\(\sigma_t^2\)是误差\(u_t\)的条件方差,\(\sigma_t\)即是所谓的波动率。均值方程一般就是前面介绍过的线性回归模型或自回归模型,所以,GARCH模型的精髓主要在方差方程。不同的方差方程,形成了不同的GARCH类模型。
GARCH模型
GARCH(p,q)模型可以表达为 $$\sigma_t^2 = \omega + \sum_{i=1}^p\alpha_i u_{t-i}^2 + \sum_{i=1}^q \beta_i \sigma_{t-i}^2 $$ 其中,\(u_{t-i}^2\) 被称为ARCH项,\(\sigma_{t-i}^2\)被称为GARCH项。这个模型被记为GARCH(p,q)而不是GARCH(q,p)是因为它实际上可以写为$$u_t^2 = \omega + \sum_{i=1}^p\alpha_i u_{t-i}^2 + \sum_{i=1}^q \beta_i \sigma_{t-i}^2 + e_t$$一个有点像ARMA(p,q)模型的形式。GARCH(p,0)也即是所谓的ARCH(p)模型。
估计GARCH类模型需要用到arch命令。打开EViews安装目录下的Example Files\EV13 Manual Data\Chapter 27 – ARCH and GARCH Estimation\stocks.wf1,假设我们要用其中的spx(标普500指数)的对数收益率估计一个均值方程为AR(1)模型的GARCH(1,2)模型,可以使用下面的代码:
smpl 10/01/1993 10/01/2000      '设定估计样本
equation eq1
eq1.arch(1,2) dlog(spx) c ar(1) 'GARCH(1,2)arch后直接跟的是均值方程。估计的结果如下图所示:

输出的结果和使用ls命令的情形差不多,只不过多了方差方程的部分。估计完模型后,仍可以用wald命令实施各种统计检验。
在实际应用中,GARCH(1,1)是用得最多的GARCH模型,因此,arch命令默认估计GARCH(1,1)模型,所以,下面的两行代码是等价的:
eq1.arch(1,1) dlog(spx) c ar(1)   'GARCH(1,1)
eq1.arch dlog(spx) c ar(1) 'GARCH(1,1)在方差方程里,除了ARCH项和GARCH项,我们还可以加入其他变量。在估计模型的代码之后加上@,然后列出想要加入的变量就可以了,例如,
eq1.arch(1,1) dlog(spx) c ar(1) @ @lag(dlog(vix),1)这行代码在方差方程里加入了vix的对数差分的一阶滞后。这里用到了函数@lag(x,n),它表示x的n阶滞后。
估计GARCH模型的鼠标操作是,选中workfile后点击主菜单的Quick/Estimate Equation,或先建一个空的equation对象,然后再点击equation对象窗口上方的Estimate按钮,两种方式都会弹出估计模型的窗口,接下来在Method处选ARCH就会出现如下对话框:

其中,Specification下的Mean equation部分用来设置均值方程;ARCH-M涉及ARCH-M模型(后面会介绍)的设置;Model可选择不同的GARCH类模型(后面会介绍);ARCH后的数字指GARCH(p,q)中的p;GARCH后的数字指GARCH(p,q)中的q;Threshold order后的数字指TARCH模型(后面会介绍)的另一个滞后阶数(后面会介绍);Restrictions用来选择IGARCH模型(后面会介绍);Variance regressors设置方差方程中纳入的其他变量;Error distribution设置误差的分布。Options下可以设置实施最大似然估计的最优化方法、参数估计量的协方差矩阵的计算方式等内容。设置好一切后,点确定就能估计模型了。
ARCH检验
设立方差方程的理念是认为误差的条件方差与过去的信息有关,这对还是不对,我们可以在GARCH模型估计完后,通过检查ARCH项和GARCH项的显著性来判断。这是一种事后的角度:先假设误差的条件方差与过去的信息有关,然后再检验这个假设有没有问题。
事实上,我们也可以从事前的角度来判断设立方差方程有没有必要:先假设误差的条件方差与过去的信息无关,然后再检验这个假设有没有问题。ARCH检验即是这样一种事前检验,它能帮助我们快速判断对一个均值方程,有无再设一个方差方程的必要。
ARCH检验的想法是,如果原假设没有问题,均值方程的残差的平方\(\hat{u}_t^2\)应该不受它的过去影响。用\(\hat{u}_t^2\)建立一个p阶自回归模型,然后检验所有滞后项的系数的联合显著性,这就是ARCH检验。在EViews中,估计完均值方程后,用archtest命令就能实施ARCH检验了:
eq1.ls(arma=cls,cov=white) dlog(spx) c ar(1) 'OLS估计均值方程
eq1.archtest(3)                              'ARCH检验,p=3
eq1.archtest 'ARCH检验,默认p=1下图为p=1时ARCH检验的主要结果:

archtest命令会报告两个检验统计量:F-statistic和Obs*R-squared,第二至四列依次是它们的数值、服从的分布和对应检验的p值。
从建模逻辑上讲,在建立一个GARCH模型之前,应先进行ARCH检验,只有拒绝了ARCH检验的原假设,才考虑进一步设立一个方差方程。但是,如果分析的数据是金融资产的收益率,ARCH检验一般不需要做,可以直接设方差方程,这是因为成千上万的研究已经表明,收益率的条件方差确实与过去的信息相关。
ARCH检验对应的鼠标模式是在equation对象窗口左上选View/Residual Diagnostics/Heteroskedasticity Tests,然后Test type选ARCH,设好滞后阶数后确定。
分布假设
GARCH模型是通过最大似然法估计的,因此,均值方程里的误差的分布需要提前设定好。EViews默认会假设误差服从正态分布,此外,也可以选择假设误差服从t分布或GED(Generailized Error Distribution,广义误差分布)。使用后两种分布主要是考虑到有些收益率序列的分布是尖峰厚尾的,当t分布的自由度比较小时或GED的尾部参数小于2时,这两种分布都是尖峰厚尾的。
使用t分布或GED只需对arch命令加上可选参数tdist或ged,例如:
eq1.arch(1,1,tdist) dlog(spx) c ar(1)   'GARCH(1,1)-t
eq1.arch(1,1,ged) dlog(spx) c ar(1)     'GARCH(1,1)-GED
注意,在上面的代码中,t分布的自由度以及GED的尾部参数会被视为未知参数,因此,输出的结果中会多出T-DIST.DOF或GED PARAMETER,它们分别对应两个参数的最大似然估计结果。我们也可直接令这两个参数等于固定的数值,例如:
eq1.arch(1,1,tdist=5) dlog(spx) c ar(1)   'GARCH(1,1)-t,自由度为5
eq1.arch(1,1,ged=1.5) dlog(spx) c ar(1) 'GARCH(1,1)-GED,尾部参数为1.5理论上讲,通过数据估计t分布的自由度或GED的尾部参数是比主观设定它们的数值要好的,但是,把它们视为未知参数会加剧模型的非线性程度,某些情况下,最大似然估计无法达到收敛。此时,一种解决方案是尝试其他的最优化方法或步长选择方式,或增加迭代次数,这可以通过arch命令的三个可选参数optmethod、optstep和maxit实现。这和[回归模型]一讲中介绍的估计非线性回归模型的情形是一模一样的。optmethod可以等于bfgs(默认)、opg、newton或legacy;optstep可以等于marquardt(默认)、dogleg或linesearch;maxit的默认值是500,可令其等于一个更大的数。
如果上述办法仍无法使收敛达成,还可以考虑另一种解决方案:把t分布的自由度设为4~10中的一些值,或把GED的尾部参数设为0.5~1.8中的一些值,估计对应的若干个模型后比较它们的似然值,然后挑选出似然值最大的模型。
如果我们的目标仅是一致地估计模型参数以及做相关的统计检验,即使是对尖峰厚尾的收益率序列,使用正态分布假设也是可以达成这一目标的,这就是所谓的QMLE(Quasi MLE):基于错误的似然函数也能一致地估计模型参数并做正确的统计检验。对GARCH模型做QMLE,只需对arch命令加上cov=bollerslev:
eq1.arch(1,1,cov=bollerslev) dlog(spx) c ar(1)模型诊断
估计完GARCH模型后,诊断检验是必不可少的。如果均值方程是一个ARMA模型,误差的白噪声检验是需要做的。我们仍可通过correl命令实施Ljung–Box Q检验:
eq1.correl(10) 'eq1是GARCH模型 注意,对GARCH模型,用于诊断检验的残差都是标准化残差\(\hat{u}_t /\hat{\sigma}_t\),而不是原始的残差\(\hat{u}_t\)。
另一个必做的诊断检验是检验方差方程的设定有没有问题。如果没有问题,我们应该预期\(u_t^2 /\sigma_t^2\)不会受它的过去影响。基于这一想法,我们可以使用两种方法进行诊断检验。第一种是利用标准化残差的平方做Ljung–Box Q检验,这可以通过correlsq命令实现:
eq1.correlsq(10) 'eq1是GARCH模型 第二种方法是利用标准化残差做ARCH检验,仍是用archtest命令:
eq1.archtest(lags=2) 'eq1是GARCH模型如果Q检验或ARCH检验不拒绝原假设,说明设定的方差方程是合理的。
如果Q检验或ARCH检验的结果显示有必要设方差方程,是不是说GARCH模型的方差方程就是合理的呢?答案是否定的。因此,估计完GARCH模型或其他你即将看到的GARCH类模型后,还需要进一步检验模型的方差方程是否设得合理。在EViews里,可以通过Sign-Bias检验来实现这一目标。
Sign-Bias检验的基本想法是,如果方差方程设得合理,那么前一期的误差的方向(即正负号)以及大小,都不会影响当前期的方差。这其实和金融里很重要的概念杠杆效应(leverage effect)或不对称效应有关,这一效应指对很多金融资产,等量的坏消息(bad news,模型中指负的误差)比等量的好消息(good news,模型中指正的误差)对资产收益率的波动率的贡献要大。实施Sign-Bias检验可通过signbias命令实现:
eq1.arch dlog(spx) c ar(1)   'GARCH(1,1)
eq1.signbias                 '实施Sign-Bias检验
检验结果如下:

其中,Sign-Bias检验消息符号的影响,Negative-Bias检验坏消息的影响,Positive-Bias检验好消息的影响,Joint-Bias是对前三种影响的联和检验,这是我们最关注的检验。如果该检验的p值很小(如图中的0.0007),则拒绝原假设。EViews里显示的原假设是标准化残差没有杠杆效应,这即是假设方差方程设得没有问题,所以,图中的结果显示对当前的数据,GARCH模型的方差方程可能是有问题的。
上述检验都可通过鼠标选择equation对象窗口左上的View/Residual Diagnostics实现。
预测
在EViews中,基于GARCH模型的预测和基于ARMA模型的预测,代码实现是完全一样的,基于GARCH模型的预测只不过是多了一个方差方程,它可以帮我们预测未来的方差。我们需要做的,就是在输入前面学过的实施预测的代码后,加上@garch,然后在其后设一个保存预测的方差的变量名就行了,例如:
smpl 10/01/1993 10/01/2000             '设定估计样本
eq1.arch(1,1) dlog(spx) c ar(1)
smpl 10/02/2000 10/17/2000             '设定预测的样本期
eq1.forecast(d, f=na) dlspxf @garch vf '预测的方差存入序列对象vf
注意,由于方差\(\sigma^2\)是一个无法观测的变量,我们虽然能用模型进行预测,但是,我们是无法评估模型的预测精度的。
命令复习
(.)arch:建立GARCH模型并估计.archtest:实施ARCH检验.correlsq(10):显示标准化残差的平方的相关图和Q统计量.signbias:实施Sign-Bias检验
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作并回答问题:根据诊断检验的结果,上面设立的GARCH(1,1)模型是合理的吗?
协整回归模型
对单位根序列\(y_t\)和\(x_{1t}\),…,\(x_{kt}\),如果它们之间处于一种长期均衡状态,则称它们之间存在协整(cointegration)关系,此时,可以直接使用回归模型:$$y_t = \beta_0 + \beta_1x_{1t} + \cdots +\beta_k x_{kt} + u_t \tag{1}$$ 在模型中,误差是平稳的序列。此时,回归系数的最小二乘估计量是一致的。
如果变量间是不协整的,则上面的模型不可用,因为此时模型中的误差是单位根序列,这会导致最小二乘估计量不一致。更可怕的是,基于它实施的系数显著性检验常常显示\(y_t\)是受解释变量影响的,哪怕它们之间一毛钱关系都没有,这就是所谓的伪回归(spurious regression):没关系也能整出有关系。
协整检验
为了防止中伪回归的招,我们需要检验单位根序列之间是否存在协整关系,这类检验被称为协整检验。如果检验显示协整关系存在,则数据可直接用来建立回归模型,如果检验显示协整关系不存在,则只能用差分到平稳的数据建立回归模型。
在协整检验中,Engle-Granger检验(EG检验)是最早出现的一个。以模型\((1)\)为例,EG检验实际上是利用模型的残差、对\(u_t\)实施的原假设为情形3的ADF检验(见[分析预备]一讲)。当原假设成立时,\(u_t\)是有单位根的,因此协整关系不存在;当原假设被拒绝时,\(u_t\)是平稳的,因此协整关系存在。注意,由于EG检验使用的是残差,这是经估计得到的数据而不是真实的数据\(u_t\),所以,对应ADF检验的临界值与直接使用\(u_t\)进行ADF检验的情形是不同的,这意味着,你在EViews中不能手动调取残差、然后用uroot命令去进行协整检验,因为uroot命令提供的临界值是错的。要实施EG检验,EViews里有单独的命令,但是,我要到下面才能告诉你它是谁、如何用。
另一个常用的协整检验是Phillips-Ouliaris(PO检验),它实际上是利用模型的残差、对\(u_t\)实施的原假设为情形3的Phillips-Perron检验。
协整回归模型
假设现在协整检验已经显示\(y_t\)和\(x_{1t}\),…,\(x_{kt}\)之间是协整的,模型\((1)\)是否就可以直接使用了呢?答案是:基本不能。事实上,模型\((1)\)只能保证最小二乘估计量是一致的,但是,传统的假设检验,如t检验,能不能用就无法保证了。
某些解释变量与\(u_t\)相关,这是所谓的内生性。对平稳数据建立的回归模型,内生性会导致最小二乘估计量不一致。在协整的情形下,内生性不会摧毁最小二乘估计量的一致性,但是,它会使得传统的假设检验失效,这就是“基本不能”的原因。
为了处理可能存在的内生性带来的问题,EViews提供了三种方法:Fully Modified OLS(FMOLS),Dynamic OLS(DOLS)和Canonical Cointegrating Regression(CCR)。不管模型模型\((1)\)是否存在内生性问题,它们都既能一致地估计模型\((1)\)中的回归系数,同时又能保证传统的假设检验可用。这三种方法对应的模型就是三种不同的协整回归(cointegrating regression)模型。
在EViews中,建立并估计一个协整回归模型需要用到cointreg命令。以EViews安装目录下的Example Files\EV13 Manual Data\Chapter 28 – Cointegrating Regression\hamilton_coint.wf1为例,该数据文件中有两个单位根序列lc(个人消费支出的对数)和ly(个人可支配收入的对数),假设我们的目标是估计下面的模型:$$lc = \beta_0 + \gamma t + \beta_1 ly + u_t\tag{2}$$注意,模型中加入了线性趋势项,这是因为lc是一个有明显上升趋势的序列。使用三种协整回归模型的代码如下:
equation eq1           'FMOLS
eq1.cointreg(trend=linear) lc ly
equation eq2           'DOLS
eq2.cointreg(trend=linear,method=dols,lltype=sic) lc ly
equation eq3           'CCR
eq3.cointreg(trend=linear,method=ccr) lc ly代码中,cointreg的可选参数trend等于linear表示在模型中加入线性趋势项,如果令其等于quadratic,会再加入二次趋势项(实际应用中基本不会用到)。注意,截距总是包含在协整回归模型中的,所以,不需要在lc后加c。可选参数method用于选择不同的协整回归模型,如你所见,cointreg默认使用的是FMOLS。对DOLS,还有一个可选参数lltype,事实上,如果令method等于dols,这个参数是必不可少的。DOLS有点像自回归,需要设定一个滞后(lag)阶数,此外还需要设定一个领先(lead)阶数,lltype就是设这两个阶数的。令lltype等于sic,EViews会通过SIC自动设置滞后领先阶数,同理,也可以令其等于aic或hqc,这时,EViews会使用AIC或HQIC。
三种协整回归模型估计的结果大同小异,下面仅以eq1为例:
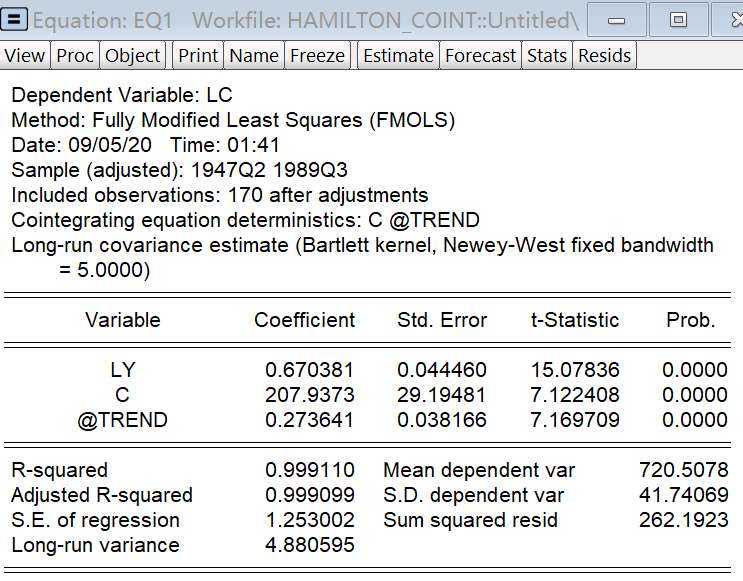
这个表和由命令ls生成的表类似。无论模型\((2)\)有没有内生性问题,表中的t统计量都可以直接使用。有一点需要注意,表最后一栏报告的七个量中,除了最底下的三个,其他都是无意义的。所以,即使你看到一个很高的R方,也不代表你找到了一个解释力很强的模型,因为R方对协整回归模型是没有意义的(请参看[为什么协整回归的R方不可信?])。事实上可以从理论上证明,R方和调整的R方,在样本量趋于无穷大时,它们都会趋于1。
估计完模型后,如果还需要做其他有关模型参数的检验,仍然可以用wald命令。
估计协整回归模型的鼠标操作是,选中workfile后点击主菜单的Quick/Estimate Equation,或先建一个空的equation对象,然后再点击equation对象窗口上方的Estimate按钮,两种方式都会弹出估计模型的窗口,接下来在Method处选COINTREG就能进行协整回归模型的设置并实施估计了。
现在,我可以告诉你怎么做协整检验了,因为在EViews中,做协整检验需要先估计协整回归模型。然鹅,如上所述,做协整检验只需要直接估计模型\((1)\)那样的传统回归模型,根本不需要估计协整回归模型。从建模的逻辑上讲,也应该是先进行协整检验,在确定有协整关系后再进入估计协整回归模型这一步。EViews弄的这个迷之操作,也是跪了。😒
由于协整检验与协整回归模型无关,所以,用哪个协整回归模型的equation对象进行协整检验,结果都是一样的。因此,下面仅介绍基于eq1的协整检验:
eq1.coint(method=eg)               'EG检验
eq1.coint(method=po,bw=neweywest) 'PO检验如代码所示,协整检验是通过coint命令实现的。可选参数method等于eg或po分别对应EG检验或PO检验。如果参数method缺失,EViews会进行默认的协整检验,我不是很推荐使用这个默认选项,原因我就不解释了。EG检验和PO检验是比默认选项更流行的单方程协整检验。对PO检验,我建议加上bw=neweywest,这个设置可以让EViews自动选择PO检验中估计长期方差的带宽参数。两种检验的主要结果如下面两张图所示:
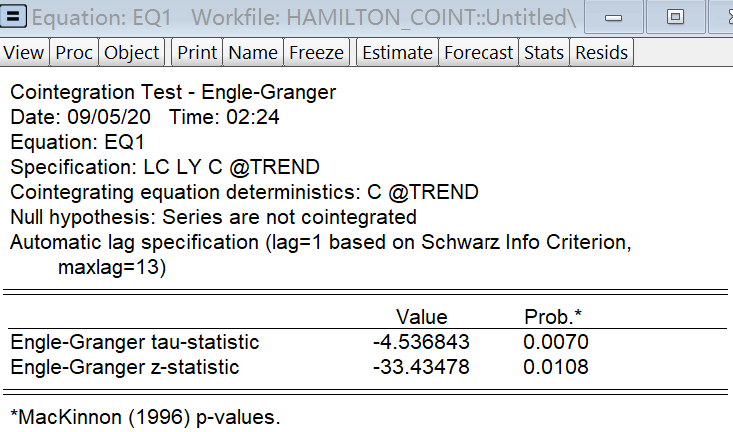
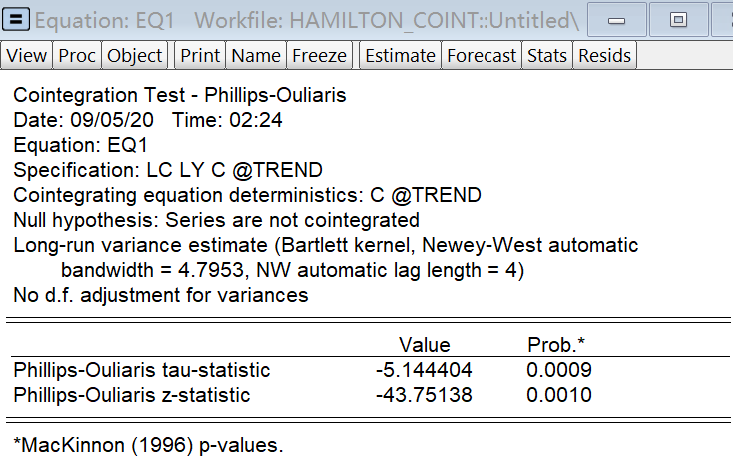
可以看到,EG检验和PO检验都会报告名为tau和z的检验统计量,根据对应的p值可直接判断在某个显著水平上要不要拒绝原假设。再提醒一下,原假设是Series are not cointegrated,别搞岔了。
鼠标模式下进行EG检验或PO检验,可以在估计完任一协整回归模型后,在equation对象窗口左上的View下选Cointegration Tests实现。
命令复习
(.)cointreg:建立协整回归模型并估计.coint:实施协整检验
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 打开EViews安装目录下的Example Files\EV12 Manual Data\Chapter 01 – Introduction\stocks.wf1,检验Apple的股票月收盘价aapl_close和IBM的股票月收盘价ibm_close之间存不存在协整关系。
北京 海淀
13.7℃ 
博文+教程
阅读
市场行情
- 上证指数
- 深证成指
- 创业板指
- 国债指数