冲击响应函数
VAR模型除了可以用来预测,也可以用来研究VAR系统中一个变量的冲击如何在系统中进行传导,进而影响模型的内生变量。一个变量的冲击,指的是以该变量为因变量的方程的误差的意外变化。
冲击响应函数
冲击响应函数(IRF,Impulse Response Functions)描述VAR系统中某一变量的冲击如何影响内生变量的未来值。以由dlcs和dlinc构建的VAR(2)模型为例:$$ x_t = dlcs_t, z_t = dlinc_t,$$ $$ \begin{bmatrix}x_{t} \\ z_{t} \ \end{bmatrix} = \begin{bmatrix}c_{1} \\ c_{2} \ \end{bmatrix} + \sum_{i=1}^2 \begin{bmatrix}A_{i11} & A_{i12}\\ A_{i21} & A_{i22} \ \end{bmatrix} \begin{bmatrix}x_{t-i} \\ z_{t-i} \ \end{bmatrix} + \begin{bmatrix}u_{1t} \\ u_{2t} \\ \end{bmatrix} \tag{1}$$ 该模型的冲击响应函数为:当变量处于VAR模型决定的期望值(稳态)、误差等于0且其他条件保持不变时,\(u_{1t}\)变化对\(\{x_{t+i}\}_{i=1}^{\infty}\)的影响,\(u_{1t}\)变化对\(\{z_{t+i}\}_{i=1}^{\infty}\)的影响,\(u_{2t}\)变化对\(\{x_{t+i}\}_{i=1}^{\infty}\)的影响和\(u_{2t}\)变化对\(\{z_{t+i}\}_{i=1}^{\infty}\)的影响。\(u_{1t}\)的变化被称为\(x_{t}\)的冲击,\(u_{2t}\)的变化被称为\(z_{t}\)的冲击。由冲击引起的\(x_{t}\)和\(z_{t}\)的变化被称为响应。
一般情况下,冲击的大小(即误差的变化量)会取为误差的一个标准差。此外,由于误差间常常是相关的:\(cov(u_{1t},u_{2t})\neq 0\),\(u_{1t}\)的变化会导致\(u_{2t}\)变化,即“其他条件保持不变”无法达成。因此,我们一般不直接考虑模型\((1)\)中误差的变化,而是先利用误差的协方差矩阵的Cholesky分解将误差正交化,然后再考虑正交化误差(它们互不相关)的变化。所以,一般情况下讲的冲击,是对正交化误差而言的。
估计完一个VAR模型后,要获得IRF可以点击var对象窗口上的Impulse,点击后会弹出如下窗口:
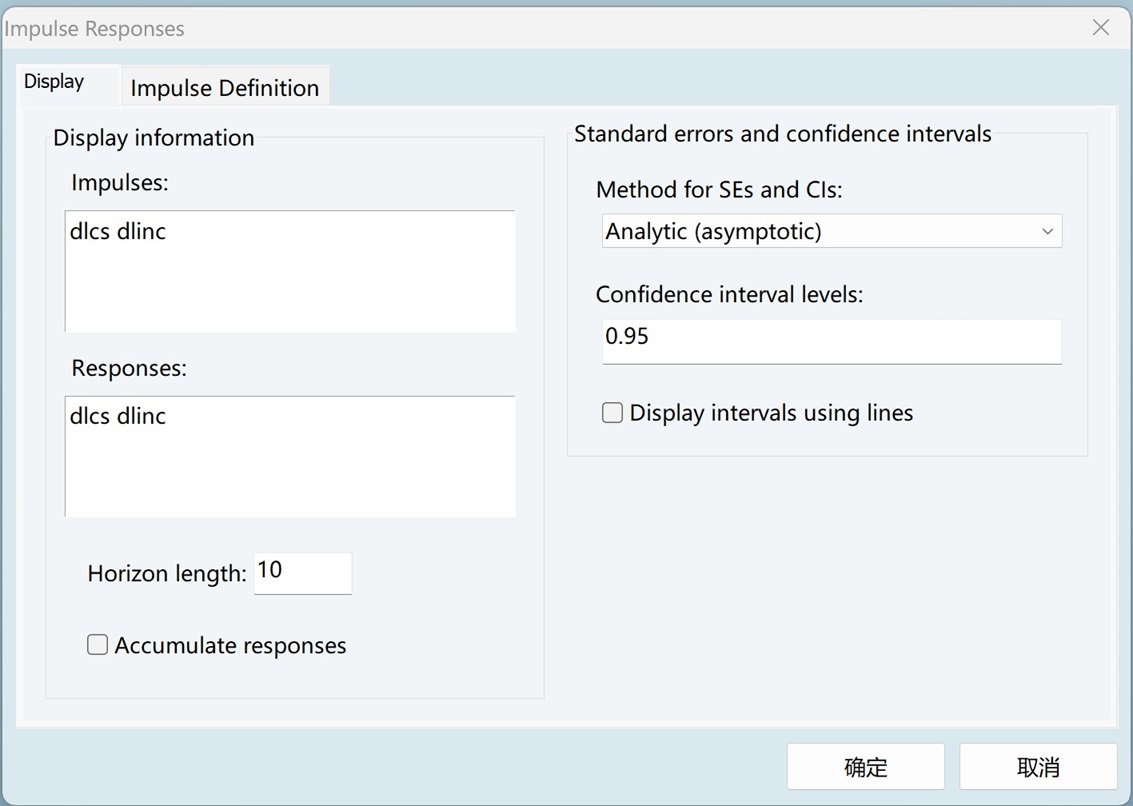
其中,Impulses下设置要查看哪些变量的冲击。Responses下设置要考虑哪些变量的响应。Horizon length设置显示多少期冲击的影响。Accumulated Responses如果勾选的话,会显示冲击的累积效应。Methods for SEs and CIs设置要不要显示响应的置信区间,以及如果显示的话用哪种标准误(默认如图所示)。Confidence interval levels设置置信区间的置信水平,默认为0.95。在这个窗口选Impulse Defination会切换到如下窗口:
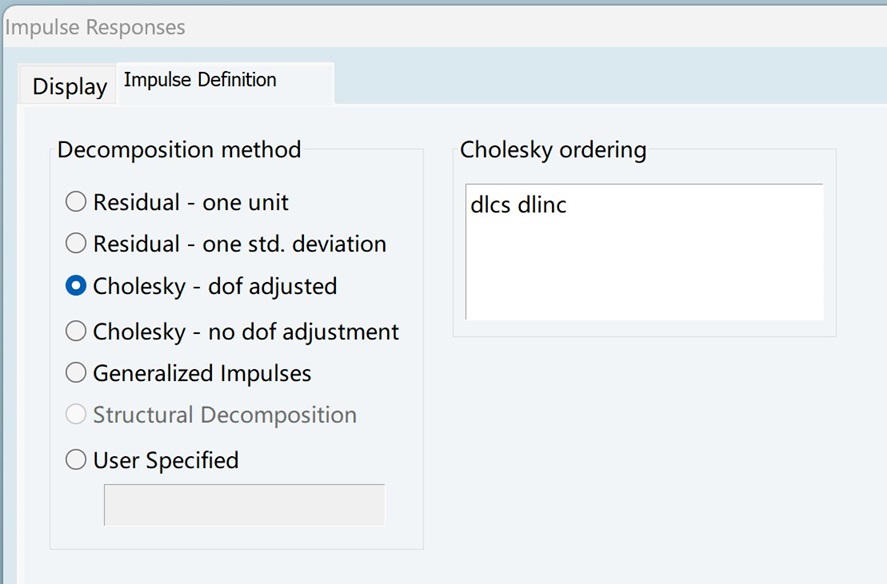
其中,Decomposition Method设置使用什么样的冲击。EViews默认选Cholesky – dof adjusted,设置冲击为正交化残差一个标准差(也是一单位)的变化,它与选Cholesky – no dof adjustment的区别在于二者计算残差协方差矩阵时后者没有进行自由度调整。Residual – one unit和Residul – one std.deviation表示冲击是原始残差一单位和一个标准差的变化。注意,这四个选项都要求在右侧的Cholesky Ordering下设置内生变量的排序,不同的排序会得到不一样的IRF,默认的排序为估计VAR模型时ls命令后内生变量的排序。Generalized Impulses是一个不一样的选项,选它将输出广义的IRF,它不依赖正交化残差,因此与内生变量的排序无关。设置好一切后,点击确定就能得到IRF。
下面我们看看在键盘模式下如何获得IRF。我们可以使用impulse命令:
var_a.ls 1 2 dlcs dlinc @restrict @l1(1,2) = 0, @l2(1,2)=0
var_a.impulse(se=a)其中,参数se用于设置响应的标准误的算法,代码中用的是EViews的默认设置。如果没有用这个参数,冲击响应图里不会显示响应的置信区间(下图中阴影部分)。代码执行的结果如下:
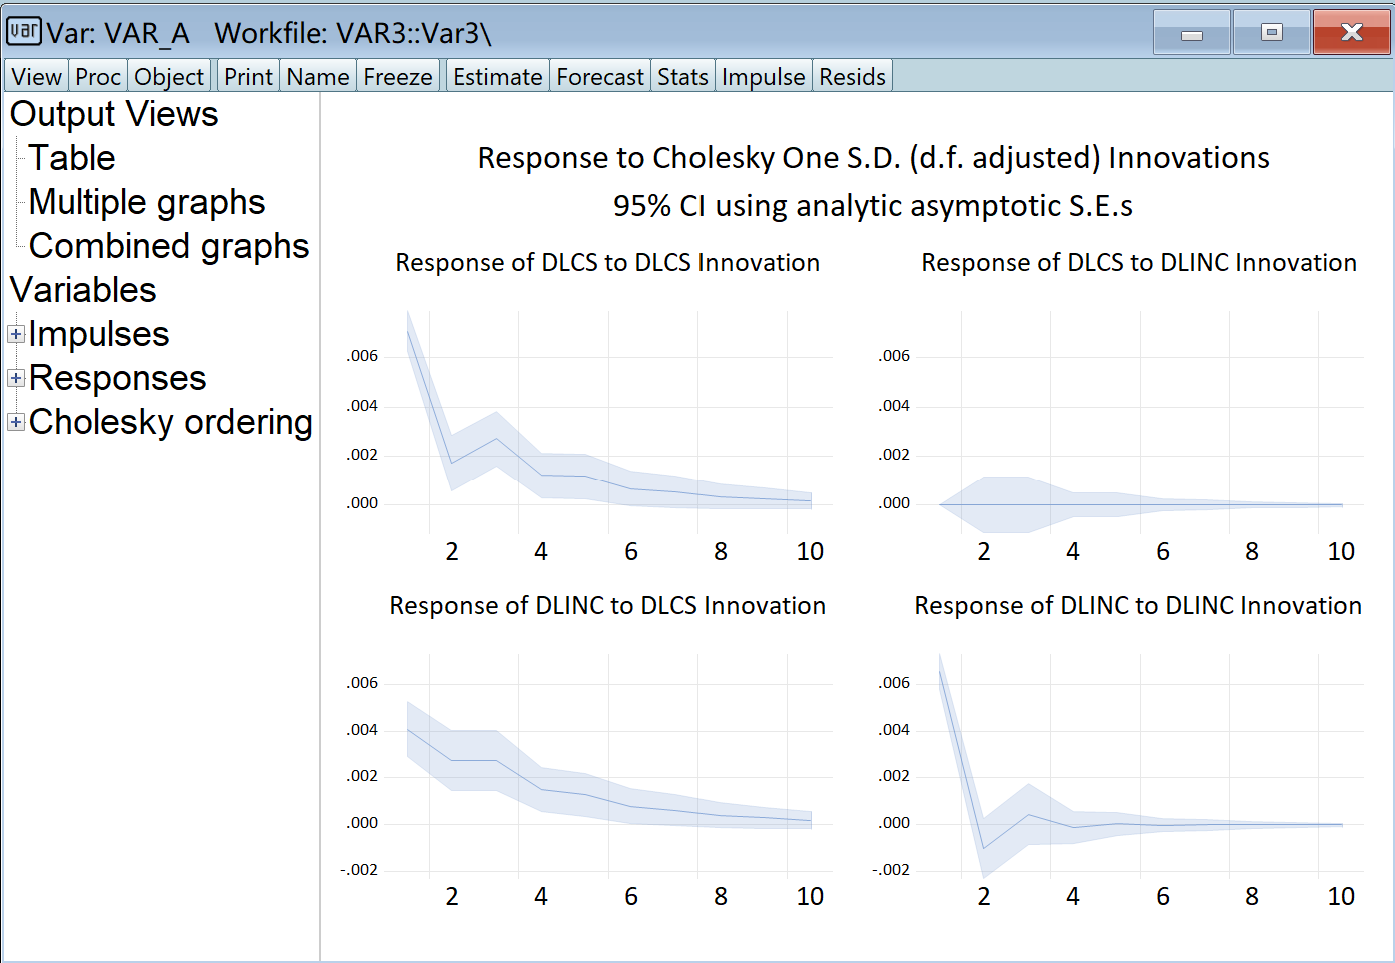
图中右侧的图是冲击响应图,两种冲击,两个内生变量,正好四张子图。图中的纵轴表示变量偏离其稳态的值。可以看到,冲击离0期越远,影响越小。此外,一个变量的冲击对它自身的影响一般比对其他变量的影响大。在图的左侧可以进行一些手动的调节,例如,把一个响应对所有的冲击放入同一张图,你可以自行探索一下。
如果我们只关心某些变量的响应,可以在impulse后直接跟上相应的变量,例如,
var_a.impulse(se=a) dlcs如果只关心某些冲击带来的影响,可以加上@imp,然后跟上相应冲击对应的变量,例如,
var_a.impulse(se=a) dlcs @imp dlinc如果想要改变默认的内生变量排序,可以利用@order,例如,
var_a.impulse(se=a) dlcs @imp dlinc @order dlinc dlcsimpulse命令有一系列可选参数可用。如果我们想要以数值方式显示IRF,可以这样:
var_a.impulse(se=a,t) 't,table之意如果想要显示冲击的累积效应,可以这样:
var_a.impulse(se=a,a) 'a,accumulated之意如果想要显示广义的IRF,可以这样:
var_a.impulse(se=a,imp=gen) 上面的例子是最常用到的可选参数设置,如果你想学习更多的可选参数及其相应的设置,你可以通过鼠标模式,利用捕获窗口进行进一步的探索。
方差分解
方差分解(variance decomposition)指的是将VAR模型的预测误差的方差进行分解,利用它可以看出预测误差的方差主要是由哪些变量的冲击导致的。实施方差分解可以选var对象窗口左上的View/Variance Decomposition,点击后会弹出如下窗口:

其中,Display Information下设置要进行方差分解的内生变量。Periods设置最多显示几步向前预测的方差分解。Factorization下默认(也只能)选Cholesky分解,这是因为和计算冲击响应函数一样,方差分解也需要使用Cholesky分解(为了保证方差的可加性),这也意味着进行方差分解也要设定内生变量的排序,在Cholesky ordering处设置。右侧设定标准误及置信区间的计算方法,默认是用Monte Carlo重抽样的方式计算,抽样次数为100次。0.95是默认的置信水平。
实施方差分解的命令是vdecomp,它的用法和impulse非常像,请看下面的例子:
var_a.vdecomp(t) dlinc @order dlinc dlcs代码中,vdecomp后直接跟要进行方差分解的内生变量(此处仅考虑dlinc),@order后设置内生变量的排序,参数t指方差分解将以数值表的形式展示代码,执行的结果如下:
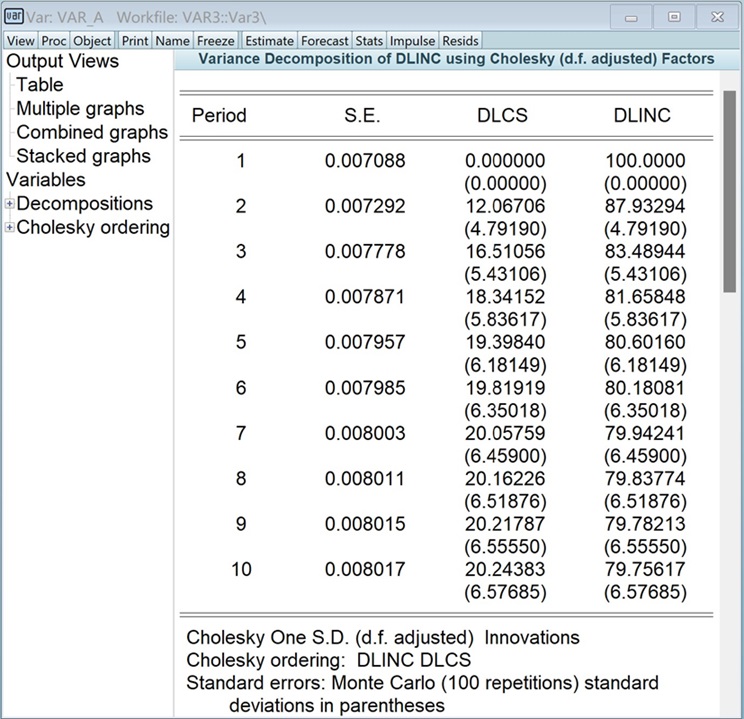
可以看到,对dlinc的一步向前预测,预测误差的方差100%来源于dlinc的冲击;对dlinc的两步向前预测,预测误差的方差有12.06706%来源于dlcs的冲击,有87.93294%来源于dlinc的冲击,…括号里的数值是对应的标准误。
以Stacked graphs的形式展示方差分解结果是比数值表更直观的方式,在EViews 13里,可以通过为vdecomp加上可选参数sg得到Stacked graphs,结果如下图所示:
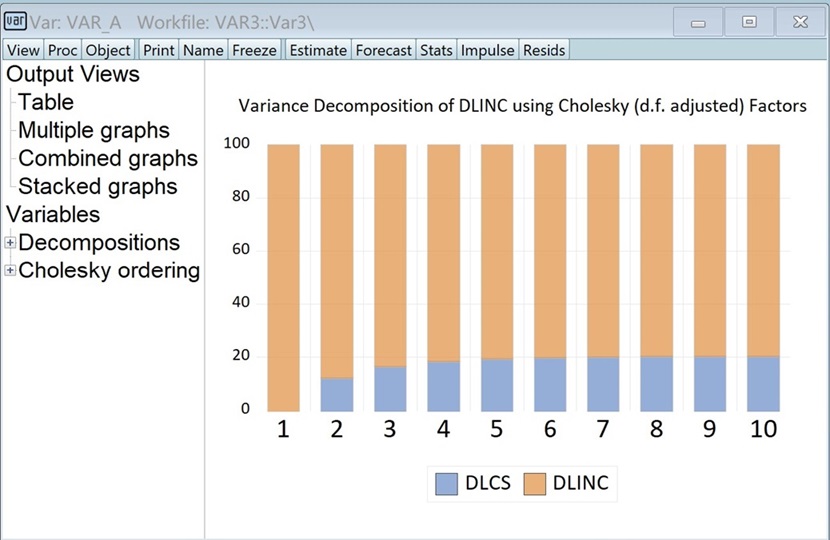
图中,不同高度不同颜色的竖条代表不同冲击对方差的贡献度。
历史分解
冲击响应和方差分解都是在看冲击带来的”平均“影响。如果我们关注一个特定的(样本内的)历史时段,好奇在那一时段内某一变量的演化主要是由哪些冲击主导的,那么我们可以利用历史分解(historical decomposition)。简单来说,历史分解就是基于已实现的历史数据,把每一个变量分解成不同冲击影响的部分的加和,外加一个近似误差。在EViews,进行历史分解的命令是hdecomp:
var_a.hdecomp 结果如下图所示:

图中的Total stochastic是两部分冲击影响的加和,绿色的线就是不同冲击影响的部分。可以看到,在全时段内,dlcs的演化基本由dlcs的冲击主导。在某些时段(如75-80年),dlinc的演化由dlcs的冲击主导;在另一些时段内(如93-95年),dlinc的演化由dlinc的冲击主导。如果我们只想看或展示某一时段的历史分解,如75Q1-80Q1,我们可以这样使用hdecomp命令:
var_a.hdecomp(start=1975q1, end=1980q1)在应用历史分解时,一个需注意的点是我们尽量不要分析样本早期的时段,因为那部分的近似误差一般会较大。
命令复习
.impulse:输出VAR模型的冲击响应函数.vdecomp:输出VAR模型的方差分解结果.hdecomp:输出VAR模型的历史分解结果
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作并以Stacked Graphs的形式输出模型的方差分解结果。
- 输入代码var_a.hdecomp dlinc,看一看对dlinc,是否还存在其他某些时段,在其中某一冲击起到了明显的主导作用。


- 版权声明:本作品使用知识共享(Creative Commons)的署名-非商业性使用-禁止演绎 4.0 国际许可协议。非商业转载请注明出处(作者及原文链接),商业转载请联系作者获得授权。

12: 请问把一个响应对所有的冲击放入同一张图这个是如何操作的
上面的var_a.impulse(se=a) dlcs就是dlcs的响应对所有冲击的图
晓晴: 請問是否能多一節介紹VECM?
原计划要写的,可能得等我有空才能完成了。。。
請問是否能多一節介紹VECM?
请问把一个响应对所有的冲击放入同一张图这个是如何操作的