VAR模型
单变量自回归模型是利用变量自身的历史信息预测变量未来的值。如果存在其他相关的变量,把它们的信息纳入预测模型也许能进一步改进预测的精度。VAR(Vector Autoregression,向量自回归)模型正是这一想法的实现。
VAR模型把单变量自回归模型扩展到了\(k\)个变量的情形:$$y_t = c + \sum_{i=1}^p A_i y_{t-i} + u_t \tag{1}$$在这个VAR(p)模型里,\(y_t\)、截距\(c\)和误差\(u_t\)是\(k\times 1\)的向量,\(A_i\)是\(k\times k\)的系数矩阵,p是滞后参数。\(y_t\)中的每一个元素都可以通过模型进行预测,它们被称为内生(endogenous)变量。注意,这里的“内生变量”和线性回归模型语境下的“内生变量”是两个概念,这里的“内生变量”来源于宏观经济学,它指由模型决定的变量(模型中等号左边的变量),而另一个概念指的是与模型误差相关的变量。在模型中等号的右边,也可以加入其他可能会影响\(y_t\),但不被\(y_t\)影响的变量,这些变量被称为外生(exogenous)变量。含有外生变量的VAR模型可以表达为:$$y_t = c + \sum_{i=1}^p A_i y_{t-i} + Ca_t + u_t$$此处的\(a_t\)为\(l\times 1\)的外生变量向量,\(C\)是对应的\(k\times l\)系数矩阵。
注意,模型\((1)\)中的未知参数有\(k+k^2\times p\)个。在样本量固定的情况下,未知参数越多,估计偏差越大,所以,为了控制未知参数的个数,实际应用中滞后参数一般不会设得很大。
模型估计与var对象 
在EViews中建立并估计一个VAR模型,你需要的配料有三样。一、平稳的内生变量。建立一个AR模型,我们要求数据必须平稳,同样,对VAR模型的建立,平稳性也是必须的。需要注意的是,如果平稳的数据是通过差分得到的,即原始的数据是有单位根的,还需要确定原始数据间没有协整关系,如果有的话,VAR模型是有缺陷的,此时应该使用VEC(Vector Error Correction,向量误差修正)模型(有机会我再介绍)。二、var对象。这一对象是专门用来处理VAR模型和VEC模型的。三、ls命令。VAR模型的估计,使用的仍然是强大的最小二乘法。
打开EViews安装目录下的Example Files\EV12 Manual Data\Chapter 44 – Vector Autoregression and Error Correction Models\var3.wf1(这一数据文件在EViews 13里已经没有了,需要可以点这里下载:var3.wf1),里面有两个变量dlcs和dlinc,它们分别是个人消费支出cs和个人收入inc的对数差分。通过单位根检验可以发现dlcs和dlinc是平稳的,但log(cs)和log(inc)是有单位根的。通过EG检验或PO检验(见[协整回归模型]一讲)可以发现log(cs)和log(inc)是不协整的。因此,dlcs和dlinc可以建立一个VAR模型。例如,要建立一个VAR(2)模型:$$ x_t = dlcs_t, z_t = dlinc_t,$$ $$ \begin{bmatrix}x_{t} \\ z_{t} \ \end{bmatrix} = \begin{bmatrix}c_{1} \\ c_{2} \ \end{bmatrix} + \sum_{i=1}^2 \begin{bmatrix}A_{i11} & A_{i12}\\ A_{i21} & A_{i22} \ \end{bmatrix} \begin{bmatrix}x_{t-i} \\ z_{t-i} \ \end{bmatrix} + \begin{bmatrix}u_{1t} \\ u_{2t} \\ \end{bmatrix} $$ 只需使用如下代码:
smpl 1960q1 1996q4
var var_a                  '创建一个名为var_a的var对象
var_a.ls 1 2 dlcs dlinc 'VAR(2)模型在ls后面的一对数字指VAR模型中滞后项的起始阶数和结束阶数,例如,要建立VAR(1)模型,它们应该设为1 1。如果模型中的滞后阶数是不连续的,例如,模型只包含一阶滞后和三、四阶滞后,这时就需要使用两对数字1 1 3 4,表示滞后阶数从1开始,然后到1结束,再从3开始,然后到4结束。更复杂的情形可以使用多对数字来表达模型。EViews中建立的VAR模型默认是包含截距的,所以,在ls后的数字对之后,直接跟内生变量就可以了。如果模型除截距外还有其他外生变量,需要在代码后加上@,然后在其后跟外生变量,注意,此时需加上c,否则模型没有截距哟。
上面var_a的估计结果为:

表中DLCS和DLINC两列对应因变量为dlcs和dlinc的方程的估计结果。红色的线提醒你系数估计值下的圆括号里的数值是相应的标准误,方括号里的数值是相应的t统计量。注意,在ARMA模型中,C指的是平稳序列的期望,但在此处,它指的是截距。系数估计值下面那一块中的R-squared等统计量的含义之前都介绍过,我就不赘述了。最下面的一块中包含的是与整个VAR模型有关的统计量:Determinant resid covariance (dof adj.)和Determinant resid covariance指的都是残差的样本协方差矩阵的行列式,只不过前者是进行了自由度调整的;Log likelihood是模型的对数似然;Akaike information criterion和Schwarz criterion是模型的AIC和SIC;Number of coefficients是模型参数的个数。
估计VAR模型的鼠标操作是,选中workfile后点击主菜单的Quick/Estimate VAR,或先建一个空的var对象,然后再点击var对象窗口上方的Estimate按钮,两种方式都会弹出估计VAR模型的窗口:

其中,VAR type选择不同的模型(默认为VAR模型);Estimation sample设置估计模型的样本期;Endogenous variables设置模型的内生变量;Lag Intervarls for Endogenous设置模型的滞后项,方式就是利用上述ls命令后面的数字对;Exogenous variables设置模型的外生变量,默认包含的外生变量是c,即截距。设置好一切后,点确定就能估计VAR模型了。
模型诊断
VAR模型是AR模型的扩展,估计完一个VAR模型,自然也需要进行模型诊断。首先,需要看一看估计的模型是否是平稳的,这要用到arroots命令:
var_a.arroots         '报告特征方程的逆根及它们的模
var_a.arroots(graph) '显示特征方程的逆根是否在单位圆内此外,还需要检验模型的误差是否是白噪声。在[ARMA模型]一讲你已学过如何用Q统计量对一个ARMA模型的误差进行白噪声检验,事实上,Q统计量也存在多变量的版本,可以同时检验多个序列是否同时为白噪声。对VAR模型,实施Q检验可以用qstats命令:
var_a.qstats(10) '数值指报告的Q统计量的最大阶数代码执行的结果如下:

表中Q-Stat和Adj Q-Stat都是Q统计量,只是后者进行了自由度调整。它们右侧的Prob.*是相应的p值。注意,当阶数小于等于VAR(p)中的p时,Q检验的p值是没有定义的,因此Q检验不可用。
进行上述诊断检验的鼠标操作为,估计完模型后在var对象窗口的左上角选View/Lag Structure/AR Roots Table、View/Lag Structure/AR Roots Graph或View/Residual Tests/Portmanteau Autocorrelation Test。
滞后参数的选择
建立一个VAR(p)模型,滞后参数p的选择非常重要,但该如何选择呢?一种方式是对比不同p对应的模型的信息准则,这可以利用laglen命令:
var_a.laglen(4) '数值为设定的滞后参数的最大值代码执行的结果如下:

表中的Lag即是p;LogL指模型的对数似然;LR指序贯修正的似然率检验统计量;FPE指最终预测误差;AIC、SC、HQ是前面介绍过的三种信息准则(当样本量大于15时,由SC确定的p一定小于等于由AIC确定的p,而由HQ确定的p介于这两个p之间)。FPE的用法与信息准则类似,最小即最优。p的选择可以使用LR、FPE、AIC、SC、HQ中的任一个,选中的p在表中已用星号*标出。
上述laglen命令对应的鼠标操作为,估计完模型后在var对象窗口的左上角选View/Lag Structure/Lag Length Criteria。
命令复习
var:创建var对象ls:估计VAR模型.arroots:报告VAR模型的特征方程的逆根.arroots(graph):显示VAR模型的特征方程的逆根的结构.qstats(10):显示VAR模型残差的Q统计量.laglen(4):显示不同p对应的VAR(p)模型的信息准则
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作。
季节性
抽样频率为季或月的经济、金融时间序列,有一些会呈现出明显的季节性,预测这样的时间序列,我们可以使用季节ARIMA(也记作SARIMA, Seasonal ARIMA)模型。季节ARIMA模型是加了特定结构的ARIMA模型,利用滞后算子\(L \),它可以表达为:$$\Phi_P(L^s)B_p(L)[(1-L^s)^D(1-L)^d y_t – \mu]= \Psi_Q(L^s)R_q(L)e_t $$ $$B_p(L) = 1 – \beta_1 L – \cdots – \beta_p L^p$$ $$R_q(L) = 1 + \gamma_1 L + \cdots + \gamma_q L^q$$ $$\Phi_P(L^s) = 1 – \phi_1 L^s – \phi_1 L^{2s} – \cdots – \phi_P L^{Ps}$$ $$\Psi_Q(L^s) = 1 + \psi_1 L^s + \psi_2 L^{2s}+ \cdots + \psi_Q L^{Qs}$$其中,\(e_t\)是一个零期望的白噪声。这个模型可记为ARIMA(p,d,q)×(P,D,Q)s。😰
ARIMA(p,d,q)×(P,D,Q)s模型在ARIMA(p,d,q)模型的基础上加了三个滞后算子多项式。\(\Phi_P(L^s)\)是季节AR多项式,其中,s是反映季节性的频率参数,对季度数据,s取4,对月度数据,s取12。\(\Psi_Q(L^s)\)是季节MA多项式。\((1-L^s)^D\)是季节差分多项式,其中,\(1-L^s\)被称为季节差分算子,\((1-L^s)y_t\)被称为\(y_t\)的季节差分。在实际应用中,一般有D+d≤1,P≤1和Q≤1,所以,这个看上去很复杂的模型,简化后其实没那么可怕。
Talk is cheap. Show me the code.
— Linus Torvalds
在EViews中,季节ARIMA模型的估计和预测和前面讲的ARMA模型差别不大,下面我以EViews安装目录下的Example Files\EV13 Manual Data\Chapter 11 – Series\hs.wf1为例进行展示。在这个wf1文件中,hs是一个有季节性的月度时间序列,如下图所示:
smpl @all
graph g1.line hs
show g1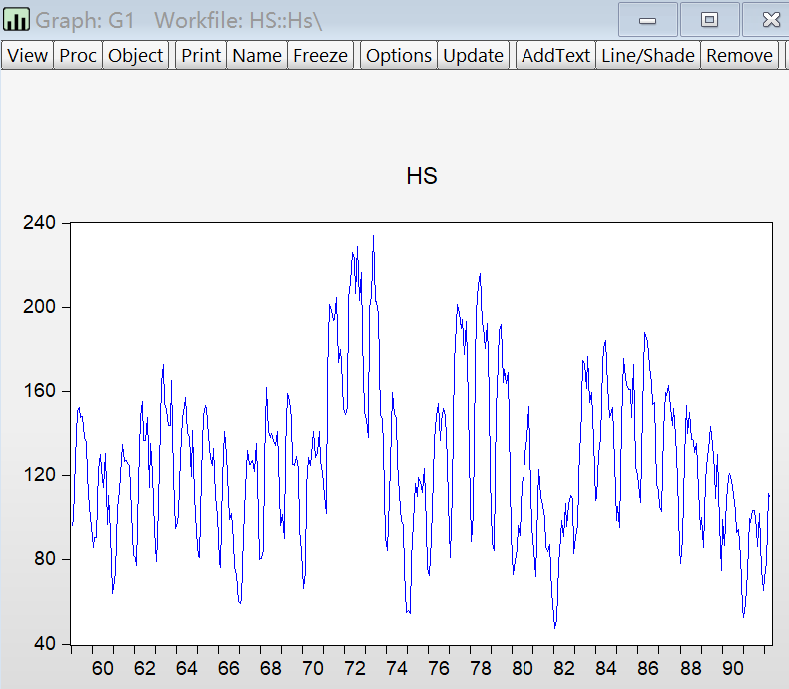
这个序列没有呈现出很规整的季节形态,这是正常的。事实上,时序图能在多大程度上呈现出季节性,完全取决于数据中季节因素与非季节因素的相对强弱。如果季节因素非常强,我们就会看到一幅非常“有规律”的时序图,如果非季节因素占主导,在时序图上我们可能连一点季节性的蛛丝都找不到,即使它确实存在。
要检查一条时间序列是否有季节性,除了看时序图,也可以看相关图。把序列先通过差分做到近似平稳的状态(如果序列本身就平稳就不需此步),然后检查它的自相关函数和偏自相关函数,如果序列有季节性,对季度数据,每隔4期会出现一次强的自相关或偏自相关,对月度数据,每隔12期会出现一次强的自相关或偏自相关。你可以用下面的代码看看hs的相关图,它的季节性一目了然。
hs.correl(36)对hs进行传统的单位根检验(见[分析预备]一讲)会发现它是一个单位根过程,因此,可以尝试用差分或季节差分后的序列建模,这意味着至少有两种季节ARIMA模型可以考虑,它们分别设D=1和d=1,例如,ARIMA(2,0,0)×(1,1,1)和ARIMA(0,1,1)×(1,0,1):$$(1 – \phi_1 L^{12})(1 – \beta_1 L-\beta_2 L^2)[(1-L^{12}) hs_t – \mu]= (1 + \psi_1 L^{12})e_t $$ $$(1 – \phi_1 L^{12})[(1-L) hs_t – \mu]= (1+\gamma_1 L)(1 + \psi_1 L^{12})e_t $$
要在建模前区分到底是用差分后的数据建模更合适,还是用季节差分后的数据建模更合适,可以使用EViews里的季节单位根检验(在序列对象窗口选View/Unit Root Tests/Seasonal Unit Root Test),这类单位根检验和传统的单位根检验很不一样,需要具备时间序列频域分析的基础知识才能理解,因此,我不打算在此介绍。其实,由于我们使用季节ARIMA模型的主要目的还是预测,因此,我们可以在估计完模型后,(通过静态预测)比较模型的预测能力,然后来判断哪个模型更合适。
要在EViews中估计上面这两个模型,仍需使用ls命令,在其后,AR和MA项仍用ar和ma表示,季节AR和季节MA项则需用sar和sma表示。请看代码:
smpl @first 1989M12     '设定估计模型的样本期
equation eqa            'ARIMA(2,0,0)×(1,1,1)
eqa.ls(arma=cls,cov=white) d(hs,0,12) c ar(1 to 2) sar(12) sma(12)
equation eqb            'ARIMA(0,1,1)×(1,0,1)
eqb.ls(arma=cls,cov=white) d(hs) c sar(12) ma(1) sma(12)上面的eqa利用了hs的季节差分建模,eqb利用了hs的差分建模,这是通过函数d()实现的。d(x,n,s)表示$$ (1-L^s)(1-L)^nx $$其中,n的默认取值是1,s的默认取值是0,所以,d(x)表示x的一阶差分。
EViews报告季节ARIMA模型的估计结果与报告ARMA模型的估计结果差别不大,下面仅展示eqa的估计结果:
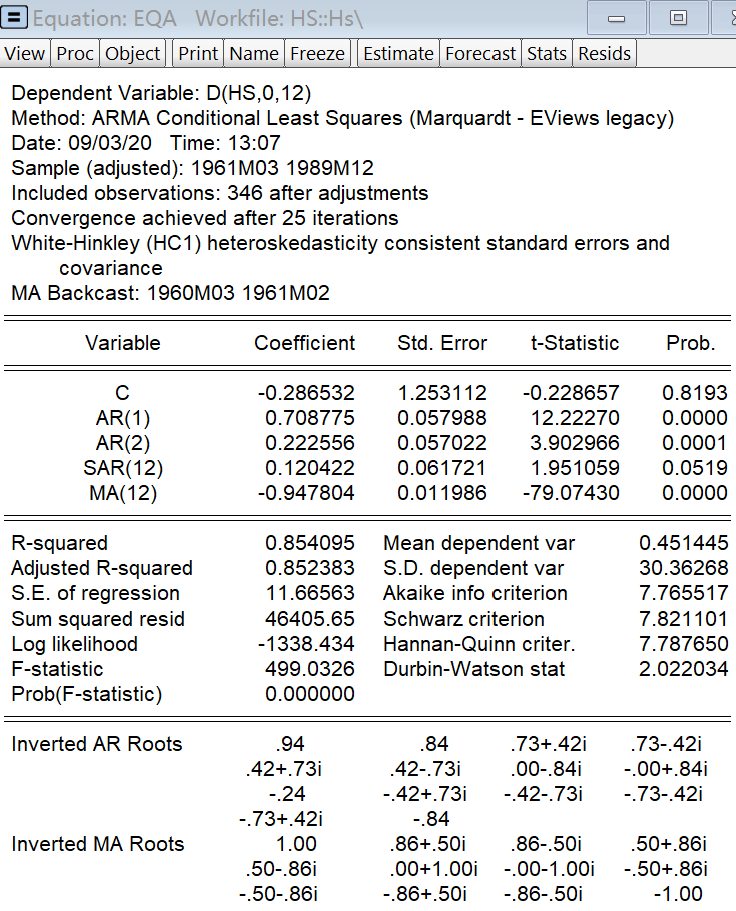
在上面的表中,SAR(12)对应季节AR项的系数。注意,eqa的估计代码中有一项sma(12),但是,表中没有SMA(12)啊!?季节MA项去哪了😖?表中有一项MA(12),这是EViews的bug吗?事实上,如果你再仔细看一下eqa这个模型,你应该能发现代码中加sma(12)和加ma(12)是完全等价的。在EViews中,如果命令ls后面只有SMA项而没有MA项,EViews会把SMA项自动转为MA项。同理,如果命令ls后面只有SAR项而没有AR项,EViews会把SAR项自动转为AR项,所以,在eqb的估计结果中,你看不到SAR(12),而只能看到AR(12),你可以试试看是不是这样。
估计完季节ARIMA模型后,进行模型诊断是必不可少的,这个在前面已经介绍过,我就不再赘述了。我想提醒的一点是,在用correl命令对模型的残差实施白噪声检验时,一定要注意残差的高阶自相关系数和偏自相关系数。例如,当你使用的是带有季节性的月度数据时,你可能会看到残差的前十一阶自相关系数和偏自相关系数都是不显著的,因此,前十一阶的Q检验都不能拒绝误差是白噪声的原假设。但是,第十二阶自相关系数或偏自相关系数却可能是非常显著的,如果有这种现象,则说明当前的模型不能很好地刻画数据的季节性,因此需要考虑其他模型。
利用季节ARIMA模型进行动态预测或静态预测和前面介绍过的没什么不同,仍是利用forecast命令或fit命令。只有一点需要注意:当模型是基于季节差分后的序列建立的(类似上面的eqa),如果预测的目标是季节差分后的数据,仍只需对forecast命令或fit命令加上可选参数d。所以,对一个季节ARIMA模型,无论它是基于差分后的序列、还是基于季节差分后的序列建立的,预测对应的差分或季节差分后的数据,加上可选参数d就行了。
命令复习
.forecast(d):对差分或季节差分后的序列实施动态预测.fit(d):对差分或季节差分后的序列实施静态预测
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 重复上面的操作,把预测的样本期设为1990M01-1992M04,利用静态预测对比eqa和eqb的预测精度。
二值选择模型
对因变量是0-1变量(即取值为0或1的变量)的情形,记因变量等于1的概率为\(p_i =\Pr(y_i=1)\)。线性概率模型假设\(p_i\)是自变量的线性函数:$$p_i=\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i}$$这是导致这一模型无法保证拟合值或预测值是一个概率值的根本原因。为了规避这样的缺点,二值选择模型(binary choice models)采用了这样的假设:$$p_i=F(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})$$其中,\(F(\cdot)\)是某一随机变量的累积分布函数。由于累积分布函数总是介于0和1间的单调不减函数,这就保证了我们总能得到合理的概率拟合值或预测值。
probit、logit和gompit
实际应用中,\(F(\cdot)\)被设为标准正态分布的累积分布函数时,对应的二值选择模型被称为probit模型;\(F(\cdot)\)被设为Logistic分布的累积分布函数时,对应的二值选择模型被称为logit模型。这两个模型是最常用的二值选择模型。EViews还提供了另外一个选择:把\(F(\cdot)\)设为Gumbel分布的累积分布函数。此时,对应的模型被称为gompit模型。
在EViews中,估计这三个模型需要用到binary命令。以EViews安装目录下的Example Files\EV13 Manual Data\Chapter 31 – Discrete and Limited Dependent Variable Models\binary.wf1为例,其中,grade是0-1变量,反映学生的学习成绩有没有进步,这是因变量;psi也是0-1变量,反映学生是否在新教学模式下学习,这是核心的自变量;gpa和tuce是反映学生学习基础的两个控制变量。利用这一数据可以研究新教学模式是否能改进学生的成绩。估计三个模型的代码如下:
equation eq_p           'probit
eq_p.binary grade c psi gpa tuce
equation eq_l           'logit
eq_l.binary(d=l) grade c psi gpa tuce
equation eq_g           'gompit
eq_g.binary(d=x) grade c psi gpa tuce容易看出,模型设置是通过binary的可选参数d来实现的,其被设置为l对应估计logit模型,其被设置为x对应估计gompit模型。下面是probit模型的估计结果:
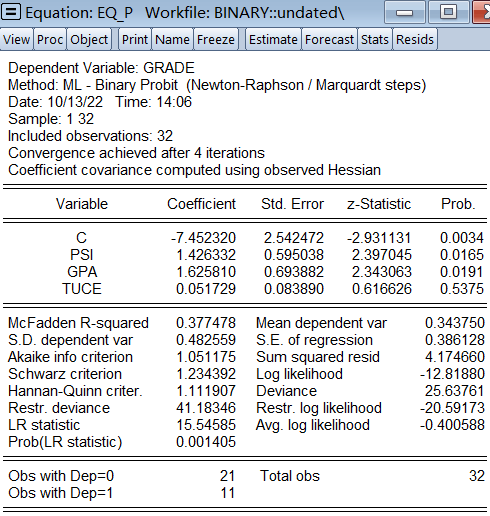
表中,系数估计的部分和之前看过的回归估计的结果类似,我们可以快速地利用p值来判断自变量是否显著。可以看出,psi在5%的显著水平下是显著的,且系数估计值大于0,因此,学生在新教学模式下学习能显著提升成绩进步的概率。系数估计下方报告的统计量中,比较有用的有McFadden R-squared(度量模型拟合优度的指标)、LR statistic和Prob(LR statistic)(检验自变量联合显著性的似然率统计量及其p值)、以及三个信息准则。在表的最下面,报告了因变量等于0或1时对应的样本量。
注意,上表显示估计二值选择模型是基于最大似然法进行的,且估计采用了数值最优化方法。因此,在估计完模型后,一定要检查最优化过程是否收敛。如果没有收敛,我们可通过调整可选参数optmethod、optstep、maxit等的取值来寻找收敛的估计结果。这些参数的含义和用法请参考[回归模型]一讲。
如果我们把最大似然估计看作QMLE,为了实施正确的假设检验,我们可以把可选参数cov设为white。
估计完模型后,如果还需要做其他有关模型参数的检验,仍然可以用wald命令。
估计二值选择模型的鼠标操作是,选中workfile后点击主菜单的Quick/Estimate Equation,或先建一个空的equation对象,然后再点击equation对象窗口上方的Estimate按钮,两种方式都会弹出估计模型的窗口,接下来在Method处选BINARY就能进行协整回归模型的设置并实施估计了。
拟合优度
除了上面提到的McFadden R-squared,另一个在应用中常用的度量拟合优度的统计量是正确预测的百分比(percentage of correct predictions)。
模型估计结束后,我们可以得到\(p_i\)的估计值:$$\hat{p}_i=F(\hat{\beta}_0 + \hat{\beta}_1 x_{1i} + \hat{\beta}_2 x_{2i})$$利用这些估计值,\(y_i\)的预测可以通过下述方式实现:$$\hat{y}_i=\begin{cases}
1 \\
0
\end{cases} \quad \text{if} \quad \begin{matrix}
\hat{p_i}> c \\
\hat{p_i}\leq c
\end{matrix} $$此处的\(c\)是一个事先选好的临界值。在没有其他信息的情况下,一般我们会取\(c\)为0.5。
正确预测的百分比的定义为:$$\frac{\sum_{i=1}^N (1-|y_i -\hat{y}_i|)}{N}$$即通过模型正确预测的样本数占总样本的比例。在EViews,估计完模型后我们可以通过predict命令报告模型的分类表,从中得到正确预测的百分比,例如:
eq_p.predict(0.51) '括号中的数值为选定的临界值代码执行的结果如下图所示:
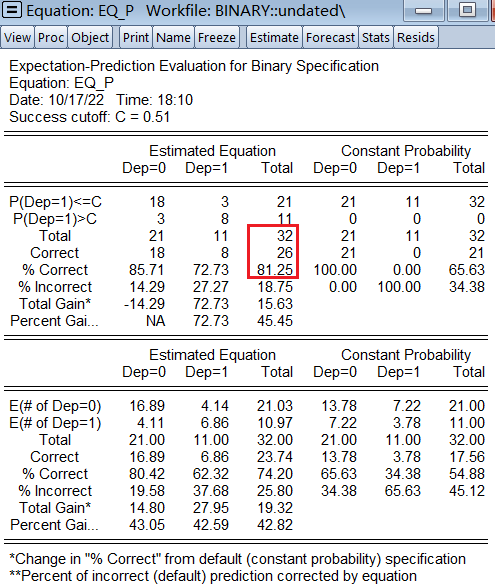
图中,红框部分包含了计算正确预测的百分比的所有信息:32是总样本数,26为正确预测的样本数,81.25%为正确预测的百分比。
边际效应与model对象 
在线性回归模型中,回归系数直接反映了自变量对因变量的边际效应(marginal effects),但是,在二值选择模型中,并不是这样。例如,如果\(x_{1i}\)是0-1变量,则\(x_{1i}\)对\(y_i\)的边际效应为:$$F(\beta_0 + \beta_1 + \beta_2 x_{2i})-F(\beta_0 + \beta_2 x_{2i})$$如果\(x_{1i}\)是连续变量,则\(x_{1i}\)对\(y_i\)的边际效应为\(F(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})\)对\(x_{1i}\)的导函数:$$\beta_1f(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})$$其中,\(f(\cdot)\)为\(F(\cdot)\)对应的概率密度函数。显然,对二值选择模型,边际效应不是一个常数,而是一个函数。为了描述自变量对因变量的平均影响,我们可以使用所有自变量取样本平均值时的边际效应,其被称为平均边际效应(average marginal effects)。
在EViews中,要计算二值选择模型在自变量取特定值时的边际效应,我们可以通过model对象(模型对象)来实现。model对象可以把若干个估计好的模型综合在一起,进而实现更复杂的预测、可视化等功能,这里的应用仅是牛刀小试。
建立model对象需要用命令model:
model me       '创建模型对象me
me.merge eq_p '把模型eq_p纳入memodel对象建立好后,我们需要选择一个方案(scenario)来完成我们想要做的事情。任何一个新建的model对象都会包含三个方案:Actuals、Baseline和Scenario 1,其中,第三个是可以自由修改的方案,我们可以选择这个方案开始我们的分析,也可以自建一个新的方案:
me.scenlist                '列出me对象中的方案(不显示Actuals)
me.scenario "scenario 1"   '选择方案Scenario 1
me.scenario(n,a="_2") "s2" '生成方案s2
me.scenario "s2" '选择方案s2方案选好后,我们需要重写(override)变量,即告诉EViews哪些自变量需要取特定的数值。例如,如果我们要计算psi的平均边际效应,我们需要把gpa和tuce取到它们的样本平均值上,然后分别计算psi取1和取0时grade等于1的概率,再做差。所以,我们需要对psi、gpa和tuce进行重写:
me.override psi gpa tuce '重写变量变量重写后,”变量名_2″将是方案s2使用的自变量的变量名,这是因为在上面生成s2的代码中,我们设定了a=”_2″。接下来,我们要对这些重写的变量进行赋值:
series psi_2 = 1
series gpa_2 = @mean(gpa)
series tuce_2 = @mean(tuce)然后,利用solve命令就可以得到基于重写变量算出的grade等于1的概率,其会被存入新生成的名为”因变量名_2″(即grade_2)的series变量中:
me.solve  '解模型对象,即根据重写的变量计算
          'Pr(grade=1),并将其存入grade_2中
          '注意,grade_2中所有的值都是相同的
scalar p1 = grade_2(1)  '生成标量p1存放Pr(grade=1|psi=1)
最后,我们需要计算psi=0的情形,进而算出平均边际效应:
series psi_2 = 0
me.solve
scalar p0 = grade_2(1)  '生成标量p1存放Pr(grade=1|psi=0)
scalar ame = p1 - p0    'psi的平均边际效应(值为0.464426)
计算连续变量的边际效应,可以利用分布函数对应的概率密度函数精确计算,也可以通过model对象近似计算。记\(F(x_{1i},x_{2i})=F(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})\),近似计算的原理为:当\(\Delta x\)很小时,\(x_{1i}\)对\(y_i\)的边际效应约等于$$\frac{F(x_{1i}+\Delta x,x_{2i})-F(x_{1i}-\Delta x,x_{2i})}{2\Delta x}$$例如,gpa的平均边际效应可以通过下面的代码近似计算:
series psi_2 = @mean(psi)
series gpa_2 = @mean(gpa)+0.00001
me.solve
scalar p1 = grade_2(1)
series gpa_2 = @mean(gpa)-0.00001
me.solve
scalar p0 = grade_2(1)
scalar ame = p1 - p0
ame = ame/0.00002       'gpa的平均边际效应(值为0.53)
需要注意的是,由于计算精度的问题,采用model对象做近似计算时,\(\Delta x\)不宜取得太小。
model对象也能让我们以更丰富的形式展示分析结果。例如,如果我们要想看在tuce取平均值、psi取0和1时,grade等于1的概率如何随gpa的变化而变化,我们可以通过如下代码来展示对应的概率变化图:
series psi_2 = 1
'利用@trend函数均匀生成在2到4间的数值,存入gpa_2
series gpa_2 = 2+(4-2)*@trend/(@obs(gpa)-1)
series tuce_2 = @mean(tuce)
me.solve
series p_1 = grade_2
series psi_2 = 0
me.solve
series p_0 = grade_2
group g1 gpa_2 p_1 p_0   '生成组对象
g1.xyline
代码执行的结果如下图所示:
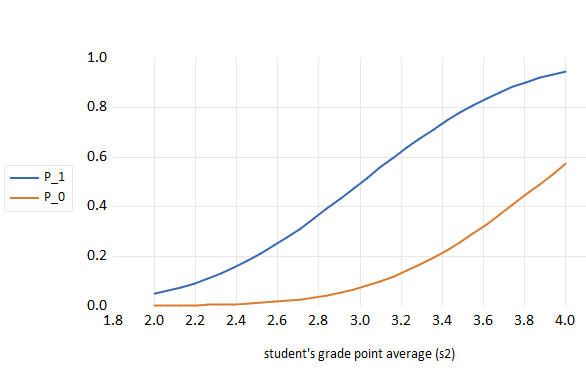
由图可以看出,当gpa较低时,新教学模式提升学生成绩的效力较弱。
命令复习
binary:估计二值选择模型.predict:报告二值选择模型的分类表model:创建model对象.merge:把已建立的模型纳入model对象.scenlist:列出model对象中的方案.scenario:选择、创建方案.override:重写变量.solve:解model对象
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 上述研究案例的logit模型的正确预测的百分比是多少?
- 估计上述研究案例的logit模型的方法如果是QMLE,检验psi显著性的p值是多少?
- 对上述研究案例的logit模型,计算psi的平均边际效应。
分析预备
利用统计模型分析数据之前,我们一般需要做一些预备的分析工作,它们能为随后的建模提供一定的依据。不同的分析情境下,需要做的预备工作可能不一样,下面,我将介绍如何在键盘模式下实现几类最常见的预备分析:报告描述性统计量;检查变量间的相关性;实施单位根检验。
描述性统计量
对截面数据、平稳时间序列数据、短面板数据,建模前常常需要看看它们的描述性统计量:变量的均值、标准差、中位数等等。通过这些统计量,我们能对数据有一个初步的了解。在EViews中,stats是用于报告描述性统计量的命令。下面我通过模拟(simulation)数据来展示其用法。
wfcreate u 500        '创建一个workfile
'生成随机数据,y扮演因变量,x扮演自变量
rndseed 123456        '设定随机数种子
series x1 = nrnd      'nrnd用于生成标准正态随机数
series x2 = nrnd
series x3 = sin(x1) + nrnd
series y = 1 + x1 - 0.5*x2 +0.5*x3 +0.5*nrnd
'------华丽的分割线------
group grp1 y x1 x2 x3  '生成组
grp1.stats             '用stats命令报告描述性统计量
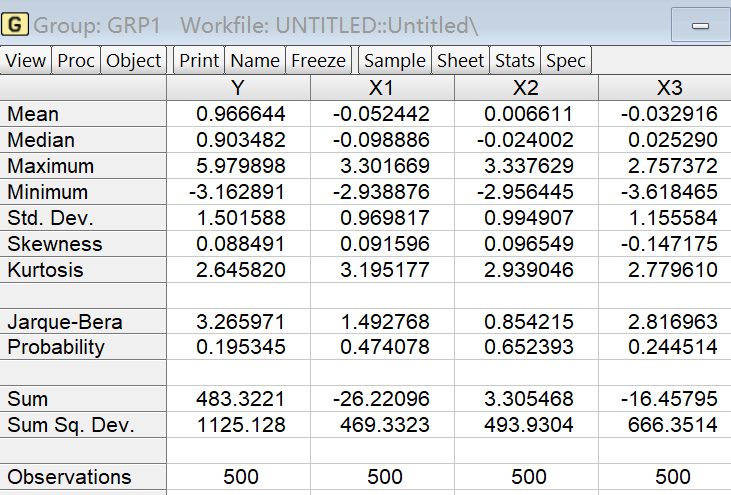
freeze(ds) grp1.stats '将结果存入表ds中倒数第二行的代码等价于在grp1窗口点View/Descriptive Stats/Common Sample。注意,在grp1窗口显示的结果和存入ds中的结果内容是一样的,但长相会有一些区别。下面是grp1窗口显示的结果:
下面是表ds显示的结果:
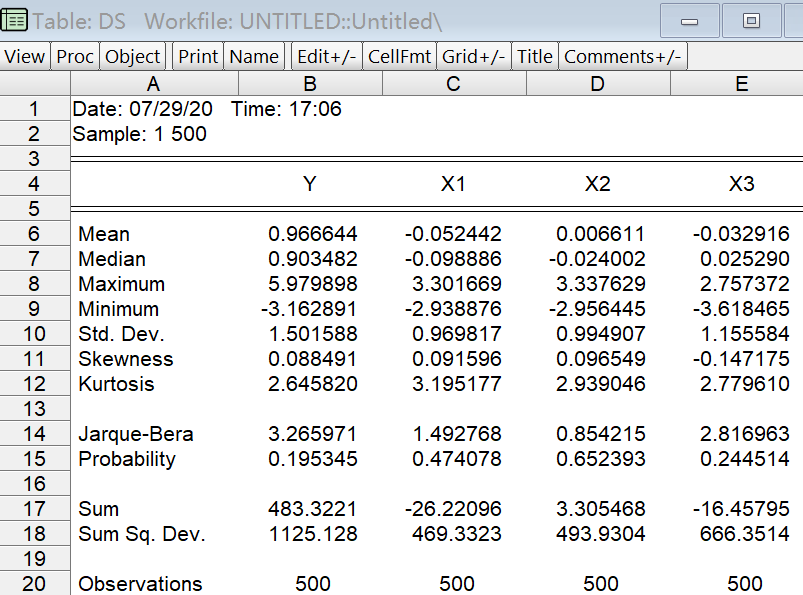
可以看到,stats命令从上到下报告了变量的样本均值、中位数、最大值、最小值、标准差、偏度、峰度、用于检验正态性的JB统计量、JB检验的p值、和、离差平方和、样本量。
相关系数
有些时候,我们会关心变量之间的相关性。例如,进行回归分析时,如果两个自变量高度相关,把它们都放入模型,很可能只有一个显著。因此,建模前看看自变量间的相关性,也许能为我们进行变量选择提供一定的信息。
常用的衡量两个变量间相关性的指标有三个:Peason相关系数、Spearman相关系数和Kendall相关系数。对每一种相关系数,我们感兴趣的值一般有三个:相关系数的数值、检验相关系数为0的统计量的数值、对应检验的p值。我们可以用命令cov报告这些数值:
group grp2 x1 x2 x3    '生成组
'在一张表内报告Peason相关系数、t统计量和对应的p值
grp2.cov(outfmt=single) corr stat prob
'在一张表内报告Spearman相关系数、t统计量和对应的p值
grp2.cov(outfmt=single) rcorr rstat rprob
'分三张表报告Kendall-b相关系数、Score统计量和对应的p值
grp2.cov(outfmt=mult) taub taustat tauprob 上面的代码中括号里的outfmt是cov命令的一个可选参数,它用来设置内容输出的格式(outfmt即output format之意)。outfmt等于single表示所有数值在一张表内报告,等于mult(multiple之意)表示每一类数值单独在一张表中报告。
括号后以空格分开的三个参数,它们的作用是告诉EViews报哪些告量。例如,rcorr表示报告Spearman相关系数,rstat表示报告检验Spearman相关系数为0的t统计量,rprob表示报告对应检验的p值。下面两张图是上面第二行和最后一行代码执行的结果:

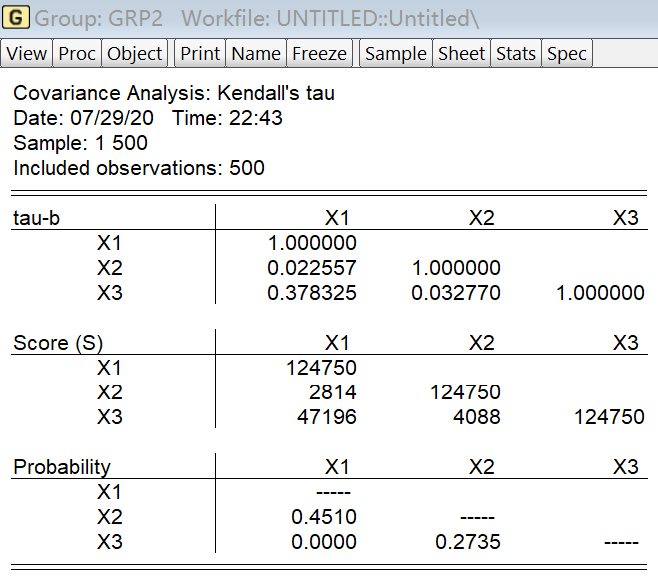
要得到这些表,也可以在鼠标模式下选择grp2窗口的View/Covariance Analysis。保存这些结果,可以选择点击窗口上的Freeze按钮,当然,键盘模式下推荐优先使用freeze命令。
单位根检验
时间序列分析中,各种模型的使用大都要先了解序列是否平稳,因此,检验序列是否有单位根几乎是建模前的必备步骤。要进行单位根检验,我们需要用uroot命令,它能实现五种单位根检验:ADF检验、DF-GLS检验、Phillips-Perron检验、ERS点最优检验、Ng-Perron检验。uroot的用法为:
序列对象.uroot(检验类型, exog = 值, dif = 值, lagmethod = 值)
上面括号里红色的部分是uroot命令的可选参数。检验类型可以是dfgls、pp、ers及np中的一种,对应除ADF检验外的四种检验,如果其缺失,则uroot命令会实施ADF检验(即默认的单位根检验)。
单位根检验的检验假设有两种情形,EViews里把它们称为Intercept(情形1)和Trend and intercept(情形2),它们的区别是:
- 情形1 — 原假设:序列含有单位根 vs 备择假设:序列是平稳的
- 情形2 — 原假设:序列含有单位根 vs 备择假设:序列是趋势平稳的
如果令参数exog等于trend,则uroot命令会检验情形2,如果不使用exog这一参数,则会检验情形1。
参数dif等于1表示对数据的差分做单位根检验,等于2表示对数据的二阶差分做单位根检验,缺失表示直接对数据做单位根检验。
实施除Phillips-Perron检验外的四种检验,都需要设置一个参数:滞后阶数。EViews提供了这样的功能:根据样本量自动设置一个最大的滞后阶数,然后在最大滞后阶数内对比不同滞后阶数设定下的模型的信息准则,进而选出“最优”的滞后阶数。参数lagmethod用来告诉EViews使用哪一种信息准则,如果这一参数缺失,EViews默认会使用SIC(即BIC),如果等于aic或hqc,则会使用AIC或HQIC。
下面是使用uroot命令几个例子:
y.uroot                '对y做情形1的ADF检验,滞后阶数由SIC自动确定
y.uroot(pp,exog=trend) '对y做情形2的pp检验
y.uroot(dfgls,dif=1,lagmethod=hqc)
                       '对y的差分做情形1的DF-GLS检验,滞后阶数由HQIC自动确定
以最后一行代码为例,代码运行后会在series对象窗口中显示如下的表:

表的标题显示了检验的类型。第一行显示了检验的原假设。注意,当前使用的数据是D(Y),即y的一阶差分。第二行的Constant表示检验情形1,如果是Constant, Linear Trend则表示检验情形2。第三行显示了自动选择的“最优”滞后阶数为12、使用的信息准则是HQIC、最大滞后阶数为17。接下来是检验的主要结果。EViews会报告检验统计量的值,以及1%、5%、10%显著水平对应的临界值,有几个检验还会报告检验的p值。
对ADF检验和Phillips-Perron检验,exog还可以设置等于none,这时,uroot命令检验的是下面的假设:
- 情形3 — 原假设:序列含有单位根 vs 备择假设:序列是零期望且平稳的
实际应用中,检验这种情形的场合非常少,所以,其他三种单位根检验在开发时都没有考虑这种情形。
EViews的uroot命令还能做一个检验:KPSS检验,它用于检验下面两种情形:
- 情形1a — 原假设:序列是平稳的 vs 备择假设:序列含有单位根
- 情形2a — 原假设:序列是趋势平稳的 vs 备择假设:序列含有单位根
进行KPSS检验,只需把检验类型设为kpss。另外,KPSS检验不需要设滞后阶数,因此,它不支持使用参数lagmethod。以下是两个例子:
y.uroot(kpss,dif=1)      '对y的差分做情形1a的KPSS检验
y.uroot(kpss,exog=trend) '对y做情形2a的KPSS检验
注意,在EViews 13中,如果做情形2a的KPSS检验,输出结果会显示Null Hypothesis: … is stationary,这实际上是不对的,应该是trend-stationary才对,但是,报告的统计量、临界值等还是可用的。
命令复习
(.)stats:报告描述性统计量(.)cov:报告变量间的相关性(.)uroot:进行单位根检验
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 把上面的代码逐条执行一遍,理解各部分的分析流程,并对比你做出的结果与上面图中展示的结果,它们是否一样?
对象
EViews的workfile不但能存储狭义的数据(数值、字符等),还能存储其他广义的数据,如图、表、矩阵、模型等。在EViews里,不同形态的数据,存储在不同的对象(object)中。下面是workfile里的各种对象类型及它们的图标,总有一款适合你。
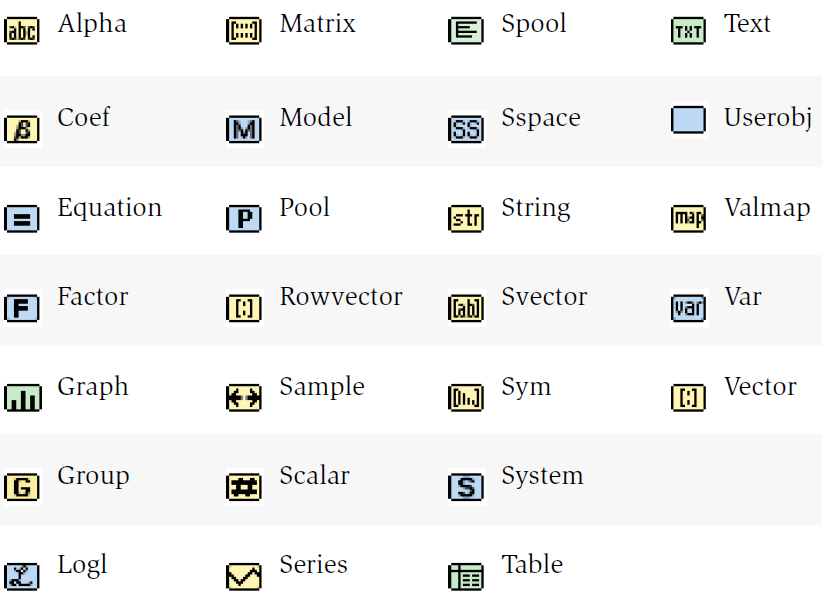
事实上,workfile本身也是一种对象类型,它的图标请见workfile窗口左上角。下面,我先简要介绍workfile里六种最常用的对象类型,其他的对象类型如果后面的教程有所涉及,到时再谈。
series对象(序列对象) 
series对象是分析中必不可少的对象类型。在[数据导入]里你已经看到,由Excel文件导入EViews的变量,要么是Date型、要么是Number型、要么是Character型。series对象是专门用来存储Date和Number型数据的对象类型。Character型数据会被存入alpha对象中,你可以把alpha对象看作是字符型的series对象。
要创建一个series对象(严格来说,创建的是对象的实例,本教程不做这么细致的区分,以免没有学过OOP的同学迷惑😁),鼠标模式下可以通过在workfile窗口右键选New Object实现,键盘模式下则需要用到命令series。series对象的创建、赋值及删除可参考以下代码:
wfcreate u 100       '创建一个临时的workfile
                     'u表示undated,即不设置特定的时间次序(适合存截面数据)
                     '100表示样本量为100
                     '这样的workfile一般用于截面数据
series x             '创建名为x的序列对象
                     'x中的"数据"都是NA,即Not Available
x = nrnd             '令x的值为从标准正态分布抽取的随机数
                     'nrnd为抽取标准正态随机数的函数
series y = x^3 - 1   '创建名为y的序列对象并赋值,值为x的三次方减1
y = NA               '清除y中的数据
y = exp(x)           '令y的值为x的指数函数值(底为自然常数)
y = y / x + 1        '令y等于当前y的值除以x再加1
y = x>=0             '若x大于等于0,则y取值为1,否则y取值为0
series z = nrnd
y = x>=0 or z<0      '若x大于等于0或z小于0,则y取值为1,否则y取值为0
y = x>=0 and z<0     '若x大于等于0且z小于0,则y取值为1,否则y取值为0
delete x y z         '删除x、y和z。delete命令可以删除任意类型的对象
代码执行的动图如下所示:object
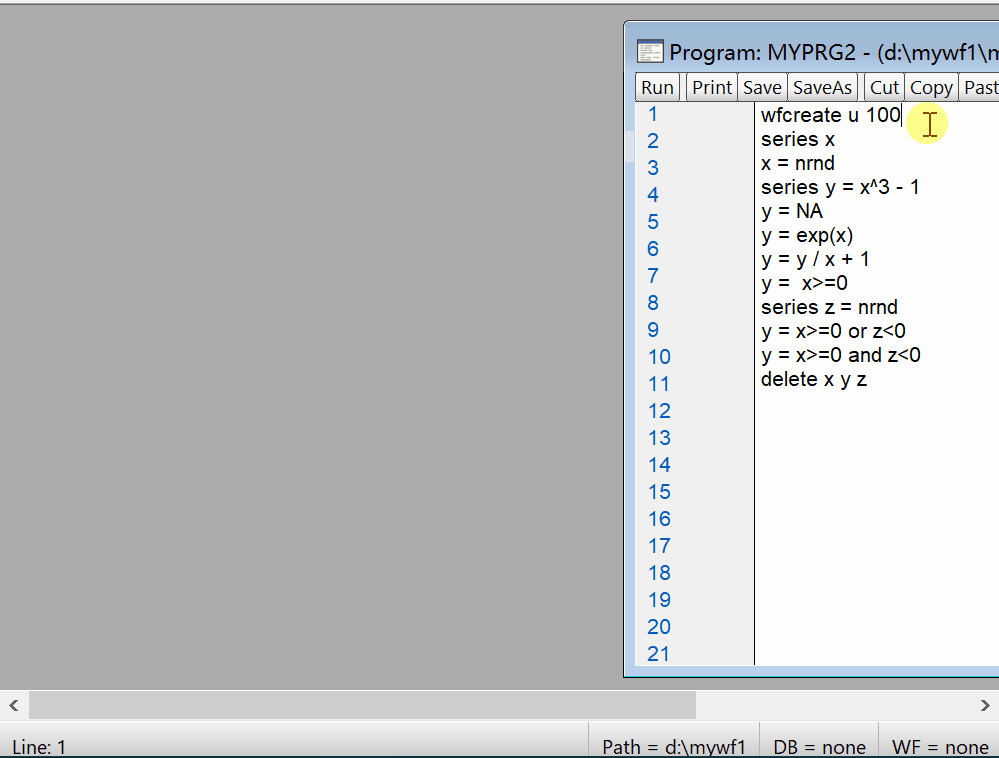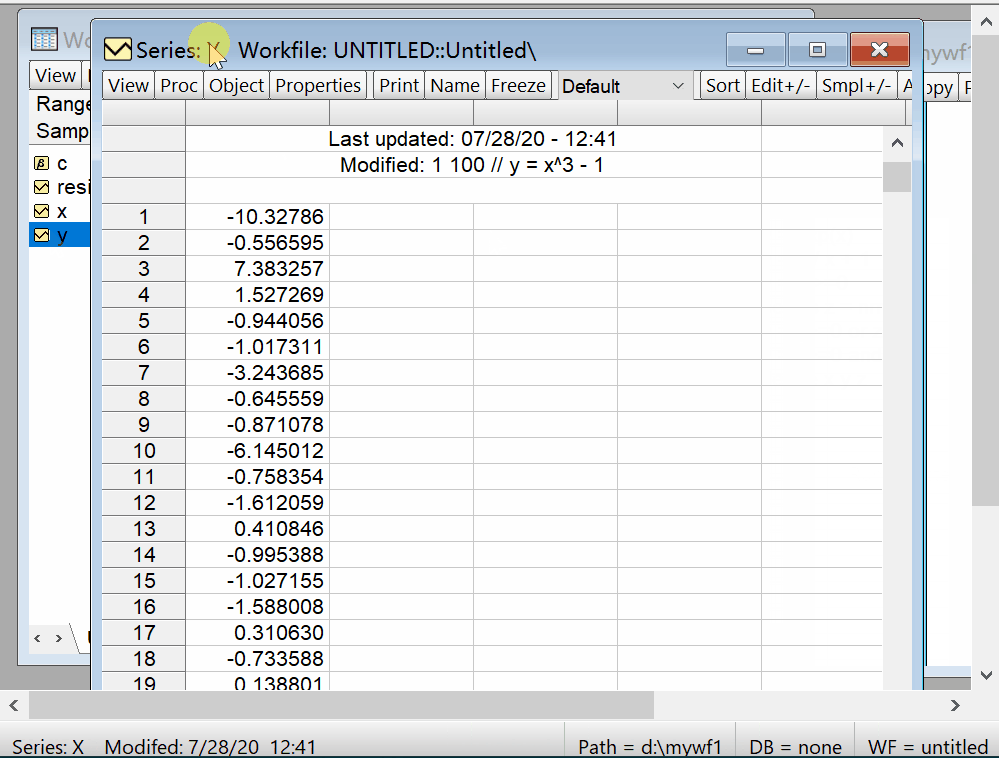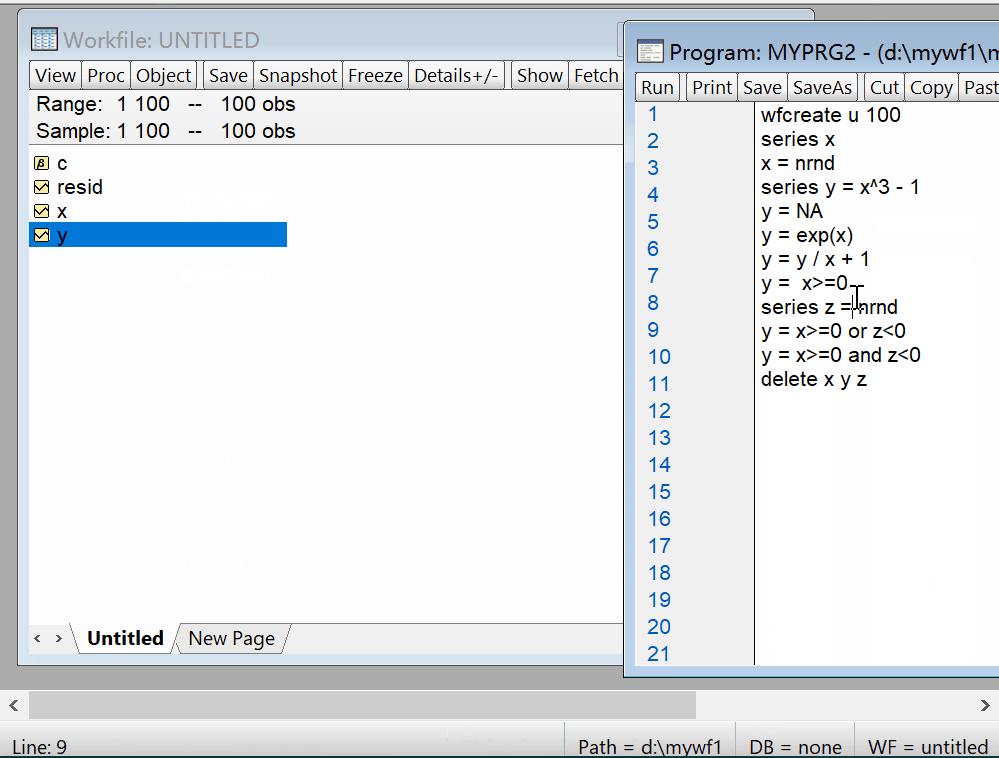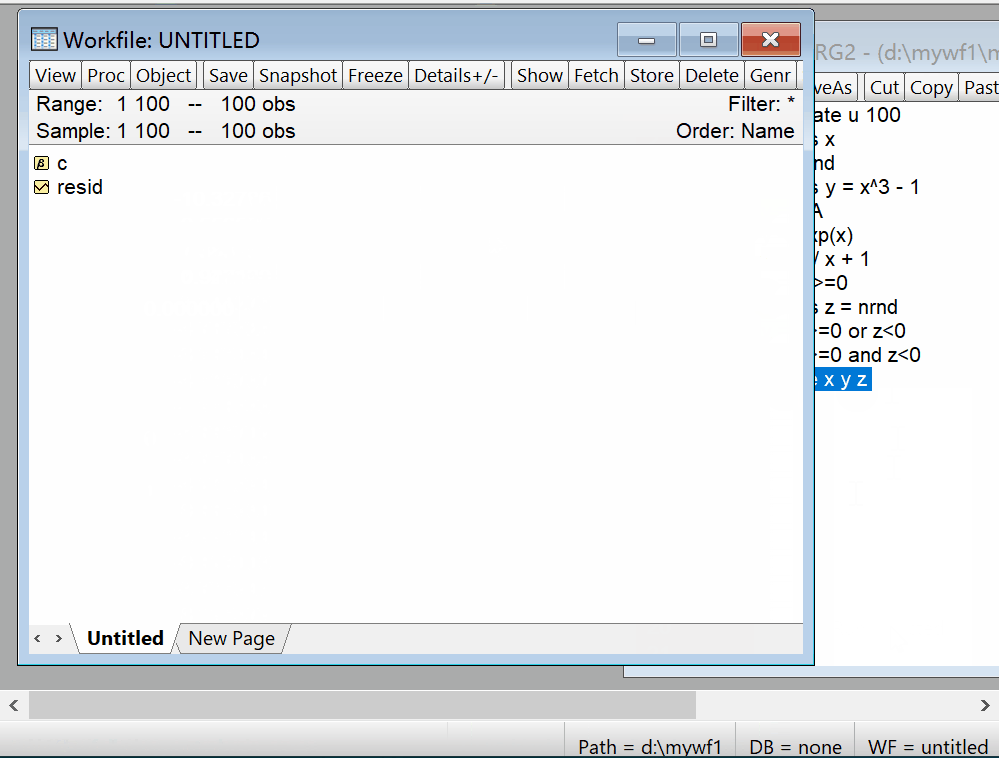
从图中可以看到,y每改动一次,y的数据表中都会加入一行修改备注:“Modified…”。EViews的这个功能可以让我们很方便地了解数据改动的历史。
如果series对象存储的是时间序列数据,我们还可以利用下面展示的函数生成新的series对象。在时间序列分析中,这些函数常被用到。
'以下代码与上面的代码无关。假设z是一个已存在的序列对象
series x
x = z(-1)            '令x等于z的一阶滞后
x = z(-5)            '令x等于z的五阶滞后
x = d(z)             '令x等于z的一阶差分,
                     '代码等价于x = z - z(-1)
x = d(z,2)           '令x等于z的二阶差分
                     '代码等价于x = z - 2*z(-1) + z(-2)
x = dlog(z)          '令x等于z的一阶对数差分
x = dlog(z,3)        '令x等于z的三阶对数差分
x = @pch(z)          '令x等于z的一期百分比变化
x = @pc(z)           '代码等价于x = @pch(z)*100,即一期的百分点变化
x = @pcha(z)         '令x等于z的年化百分比变化
x = @pca(z)          '代码等价于x = @pcha(z)*100
x = @pchy(z)         '令x等于z的同比百分比变化
x = @pcy(z) '代码等价于x = @pchy(z)*100解释一下@pch(z)、@pcha(z)和@pchy(z)之间的区别:假设\(z_t\)是季度时间序列,则这三个量分别对应$$ \frac{z_t – z_{t-1}}{z_{t-1}}$$ $$(1+\frac{z_t – z_{t-1}}{z_{t-1}})^4 – 1$$ $$\frac{z_t – z_{t-4}}{z_{t-4}}$$可以看出,后两个量依赖时间序列的抽样频率,如果\(z_t\)是月度数据,公式中的4应变为12。
对series对象(以及alpha对象),它们还存在一种自动更新的形式。举个例子,如果你先用series x = log(z)生成了z的(自然)对数值,随后改了z的值,x的值是不会有一丝变化的。有些时候,你可能更希望z的值一旦有变,x的值也会随之变变变。如果是这样,你可以用frml命令(formula之意)生成自动更新的series对象:
series x1 = log(z)   'x1生成后其值不再与z相关
frml x2 = log(z)     'x2的值会随z的值变化而自动更新
为了区分一般的series对象和自动更新的series对象,EViews在workfile中用了两种相似但又有些不同的图标。下图左侧的图标表示常规的series对象,右侧的图标表示自动更新的series对象。
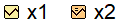
group对象(组对象) 
有些时候,为了便于分析,我们可能需要对workfile中的series对象(以及alpha对象)进行分组,这可以通过group命令创建group对象实现。例如:
group grp1           '创建名为grp1的组对象
grp1.add x y z       '向grp1加入序列对象x、y、z
grp1.drop z          '从grp1中移除z
group grp2 x z '创建名为grp2的组对象并将x和z加入其中在第二、三行代码中,grp1后有一个点号。点号在EViews中有两种角色,要么在数字中表示小数点,要么会以“对象.命令”的形式出现,表示点号后的命令作用到点号前的对象上。点号后的命令,是专属于点号前的对象的命令,是对象自带的一种方法。注意,“同样”的命令,可能会同时服务几个对象,例如:
x.sheet              '以数据表的形式展示序列对象x的数据
grp1.sheet '以数据表的形式展示组对象grp1的数据这里的两个sheet,实际上不是同一个命令,而是分别定义在序列对象和组对象上的两种方法,只不过它们取了同样的名字。
建立group对象也可以按住Ctrl键在workfile里选中相应的series对象,然后右键Open/as Group,这会建立一个临时的group对象。
graph对象(图对象) 
graph对象用来绘制和存储数据分析中需要的图。创建一个graph对象要用到命令graph,其用法与series和group类似。需要注意的是,与创建series对象或group对象不同,我们不能创建一个没有内容的graph对象。如果你执行代码graph g1想要创建一个名为g1的graph对象,EViews会弹出一个对话框让你确定要画哪些变量的时间序列图(画时序图是EViews的默认选项)。所以,如果你想在不受弹窗影响的状态下实现graph对象绘图,一定要在生成graph对象时,同时在对象后加上点号和绘图命令。以下是一些例子:
graph g1.line x      '生成图对象g1并在其上画x的时序图
show g1              '在工作区域显示g1上的图
close g1             '关闭g1的显示
graph g2.distplot x  '生成图对象g1并在其上画x的直方图
group grp1 x y z
graph g3.line grp1   '在g3上画x、y、z的时序图(画在一张图上)
grp1.drop x
graph g4.scat grp1   '在g4上画y、z的散点图,y在横轴
                     '代码等价于graph g4.scat y z
graph g5.xyline grp1 '在g5上画y、z的折线图,y在横轴
'代码等价于graph g5.xyline y z代码中,line的作用是画时序图,distplot的作用是画直方图,scat的作用是画散点图,xyline的作用是画折线图。show和close用来在工作区域显示和关闭一个对象,相当于用鼠标点开和关闭一个对象。
仅执行graph对象点号后的代码也是可行的。例如,执行distplot x,EViews会建立一个临时的graph对象显示x的直方图,要想在workfile里保存这个graph对象,可以在点击关闭对象窗口时选Name给它取一个名字。
画图还可以直接在series或group对象上实现:选择series或group对象窗口菜单的View/Graph;也可以用命令实现,例如:
x.line               '画x的时序图
x.distplot           '画x的直方图
group grp1 x y z
grp1.line            '把x、y、z的时序图画在一张图上
grp1.line(m)         '把x、y、z的时序图分别画在一张图的三张子图上
'm即multiple之意注意,在series对象或group对象上画图不会改变它们的对象类型,所画的图可以看作是隐性的graph对象,要保存可以点击窗口上方的Freeze按钮,点击后选OK会生成一个临时的graph对象,然后关闭它选Name取名就可以了。
事实上,一个对象的窗口上只要有Freeze按钮,你就能在workfile里存下任何在窗口中显示的内容,保存下的内容要么会被存入一个graph对象中,要么会被存入一个table对象中(见下文)。
在键盘模式下,使用freeze命令能一步实现上述的鼠标操作:
freeze(g1) x.distplot   '把x的直方画入新建的图对象g1中
                        '代码等价于graph g1.distplot x
group grp1 x y z
freeze(g2) grp1.line    '把x、y、z的时序图画入新建的图对象g2中
'代码等价于graph g2.line grp1对graph对象里的图,我们可以轻松地修改它的标题、坐标轴字体字号、颜色等各种属性,以及增减各种内容。你可以在graph对象窗口右键选Options、Add text、Add lines & shading、Draw,也可以直接双击图上想要修改的地方,EViews会弹出相关的对话框方便你做修改。当然,这些操作都可以用命令实现,由于内容太过琐碎,这里就不介绍了,你若感兴趣可以在EViews主菜单的Help/PDF Docs里探索探索。
graph对象里的图可以存到硬盘上,右键选Save graph to disk就行。你也可以右键选Copy to clickboard,然后把它直接粘贴到,比如,word文档里。
equation对象(方程对象) 
在数据分析中,equation对象一般是不会缺席的,建立统计模型、实施参数估计和统计检验、绘制相关图形都是在它上面完成的。注意,EViews中存在所谓的model对象(模型对象),但它是用于多方程联合分析的。所以,通常意义下我们讲的“建立模型”,指的就是用equation对象建立统计模型。
equation对象一般是和具体的模型、相关的估计、检验、画图命令联合使用的,后面的教程会有更详细的介绍,现在我们仅看看如何创建一个不含任何内容的equation对象。如果你仔细看了前面的内容,我猜你应该能想到创建equation对象的命令,没错,就是equation:
equation eq1 '创建一个名为eq1的方程对象打开一个空的equation对象,对象窗口会显示“Equation does not have estimates”。
table对象(表对象) 
table对象看上去有点像Excel,由单元格组成,它主要用来保存模型估计或检验的结果,属于文字、数字类型的结果。如果不是出于编程需要,我们一般不会用table命令去创建空的table对象。我们创建的table对象一般都是有具体内容的,而且,使用的命令仍是freeze,请见下面的例子:
'假设eq1是一个有估计结果的方程对象
freeze(tab1) eq1        '把eq1中的估计结果存入新建的表对象tab1中
freeze(tab3) x.stats    '把x的描述统计结果存入新建的表对象tab3中
rename tab3 tab2 '把对象tab3的名称改为tab2注意,用freeze命令创建graph或table对象,都是在后台默默进行的,你要查看对象里的内容,需要用show命令。
我们可以对graph对象进行修改,同样,也可以对table对象进行修改,如插入文字、改变文字颜色等。在任一单元格处点右键,EViews会给你指引。
sample对象(样本对象) 
每一个workfile,其窗口上方Range处会显示数据的总样本,下图分别是截面数据与时间序列数据的两个例子:
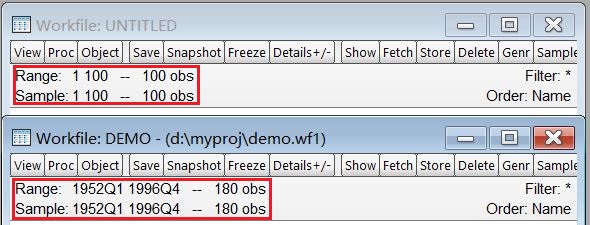
第一个Range处显示样本由1开始,到100结束,共有100个观测值(obs)。第二个Range处显示样本由1952年第一季度开始,到1996年第四季度结束,共有180个观测值。
在实际分析中,基于不同的原因,我们可能不会使用总样本去分析,而是只使用某些子样本,这时,我们就需要选定用于分析的样本。在上图中,Range下的Sample处显示的即为当前选定的用于分析的样本,默认状态下,选定的样本为总样本。
sample对象是专门用来设定分析样本的对象,生成sample对象需要用到命令sample,下面是一些例子:
sample sp1 1953q1 1963q2
'生成名为sp1的样本对象,样本由1953年第一季度开始到1996年第二季度结束
sample sp2 @all if x>0 and z<0
'生成名为sp2的样本对象,选择满足x>0且z<0的样本
sample sp3 @first+1 @last
'生成名为sp3的样本对象,样本由第二个样本点开始,到最后一个样本点结束sample对象生成后,需要用smpl命令告诉EViews开始使用对应的样本,例如:
smpl sp1 '使用sp1设定的样本使用smpl设定样本也可以直接跳过生成样本对象的步骤,例如:
sample sp1 1953q1 @last-1 if x>=0
smpl sp1
'上两行代码等价于
smpl 1953q1 @last-1 if x>=0
命令复习
wfcreate:创建workfileseries:创建series对象.sheet:以数据表的形式展示数据frml:创建自动更新对象group:创建group对象.add:向group对象里加入series对象.drop:从group对象里移除series对象graph:创建graph对象(.)line:画时间序列图(.)distplot:画直方图(.)scat:画散点图(.)xyline:画折线图equation:创建equation对象show:在工作区域显示对象close:关闭对象显示freeze:创建并保存graph对象或table对象delete:删除对象rename:更改对象的名称sample:创建sample对象smpl:设定样本
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 将数据文件stocks放入D盘的myproj文件夹中,然后创建一个prg文件,利用代码打开这一文件。
- 画出IBM的股票月收盘价ibm_close的时间序列图并保存到一个graph对象中。
- 利用aapl_close和ibm_close生成Apple和IBM股价的月收益率时间序列(以百分点表示),保存到两个series对象中。
- 将两个收益率序列组建一个group,在一张图上画出两条时间序列并保存到一个graph对象中。
- 把样本设为2006年2月到2010年8月。
自相关
对时间序列回归模型(time series regression model),误差不仅可能会有异方差的问题,还可能会有自相关(autocorrelation)的问题。自相关也叫序列相关(series correlation)。自相关和异方差很像,它本身不会影响最小二乘估计量的一致性,只影响最小二乘估计量的有效性,且会让传统的计算估计量协方差矩阵的算法失效,进而使得传统的统计检验不再可用。所以,处理自相关的方式与处理异方差类似,我们只需找到正确的计算协方差矩阵的方法就行了。幸运的是,正确的计算方法还真有,算出的协方差矩阵及相应的标准误被称为HAC(heteroskedasticity and autocorrelation consistent,异方差和自相关一致的)协方差矩阵和标准误。
HAC检验
基于HAC协方差矩阵的统计检验被称为HAC检验,不管模型有没有异方差问题,也不管模型有没有自相关问题,HAC检验都可用。在EViews中,告诉软件使用HAC协方差矩阵仍然要用到可选参数cov,标准的用法是让其等于hac,例如:
equation eq4.ls(cov=hac) y c x1 x2 x3估计结果如下:

红线和红框部分的解释与cov=white的情形相同,我就不赘述了。
鼠标模式对应的操作是在估计模型的对话框里选Options,然后把Covariance method设为HAC(Newey-West)。Newey和West是两位计量经济学家,它们提出的估计HAC协方差矩阵的方法是EViews中的默认方法,虽然还有其他方法可选,但一般使用默认的就可以了,所以,记住cov=hac就行。
在使用最小二乘法的前提下使用HAC协方差矩阵,有一个点需要注意:如果回归模型的右侧含有因变量的滞后项,一般不用HAC协方差矩阵。例如,$$y_t = \beta_0 + \beta_1 x_t + \gamma y_{t-1} + u_t$$逻辑是这样:我们用HAC协方差矩阵是为了应对自相关问题,但是,如果\(u_t\)存在自相关,这类模型一般会有内生性问题,因此,最小二乘估计量一般是不一致的,所以,无论用什么协方差矩阵,都做不了正确的统计推断。
也就是说,对上述这类模型,如果最小二乘估计量是一致的,误差一般是没有自相关问题的,因此,我们最多只需要使用异方差一致的协方差矩阵即可。如果最小二乘估计量是不一致的,我们就需要更换估计方法,那种情况下,统计推断就是另一个故事了。
自相关检验
上面的介绍意味着,如果回归模型的右侧含有因变量的滞后项,检验误差是否具有自相关是一个必须要做的诊断检验。EViews里提供的自相关检验是Breusch-Godfrey LM检验,这个检验假设回归误差如果有自相关的话,它会源于一个自回归模型:$$u_t = \rho_1 u_{t-1} + \cdots + \rho_p u_{t-p} + e_t$$其中,\(e_t\)是一个零期望的白噪声。检验自相关,等价于检验所有的\(\rho\)都等于0。
实施Breusch-Godfrey检验需要用到auto命令,它的用法与white命令类似:
eq1.auto(4) '括号中的数字指上述自回归模型的滞后阶数p,需自行设定对应的鼠标模式是在equation对象窗口左上选View/Residual Diagnostics/Serial Correlation LM Test,然后输入对应自回归模型的滞后阶数。检验结果如下图所示:
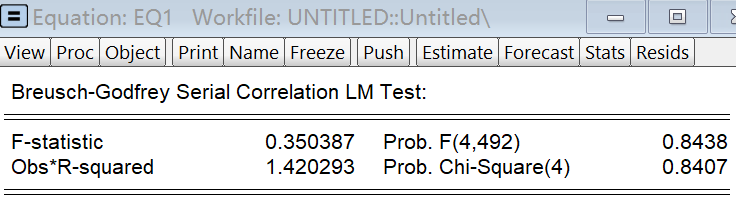
EViews会报告两个检验统计量的数值、对应的分布以及它们的p值,根据这两个统计量得出的推断结论一般不会有分歧,如果有的话,你可以只看第二个统计量:Obs*R-squared。
前面介绍过,命令ls报告的结果中含有DW统计量,它一个古老的用于检验误差自相关的统计量。相比于Breusch-Godfrey检验,基于DW统计量的自相关检验有很多缺点,在现时的应用中已很少有人用它了,所以,忘了DW统计量吧。
命令复习
(.)ls(cov=hac):实施最小二乘估计并使用HAC协方差矩阵.auto(c):实施Breusch-Godfrey检验
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 利用[数据导入]一讲练习中生成的demo.wf1,用m1的年化增长率做因变量(回顾一下函数
@pca),gdp的年化增长率做自变量,建立一个一元线性回归模型。模型是否有自相关问题(滞后阶数设为4)?对每个参数的显著性,HAC检验的结果与传统检验的结果是否相同?
北京 海淀
13.7℃ 
博文+教程
阅读
市场行情
- 上证指数
- 深证成指
- 创业板指
- 国债指数