分析预备
利用统计模型分析数据之前,我们一般需要做一些预备的分析工作,它们能为随后的建模提供一定的依据。不同的分析情境下,需要做的预备工作可能不一样,下面,我将介绍如何在键盘模式下实现几类最常见的预备分析:报告描述性统计量;检查变量间的相关性;实施单位根检验。
描述性统计量
对截面数据、平稳时间序列数据、短面板数据,建模前常常需要看看它们的描述性统计量:变量的均值、标准差、中位数等等。通过这些统计量,我们能对数据有一个初步的了解。在EViews中,stats是用于报告描述性统计量的命令。下面我通过模拟(simulation)数据来展示其用法。
wfcreate u 500        '创建一个workfile
'生成随机数据,y扮演因变量,x扮演自变量
rndseed 123456        '设定随机数种子
series x1 = nrnd      'nrnd用于生成标准正态随机数
series x2 = nrnd
series x3 = sin(x1) + nrnd
series y = 1 + x1 - 0.5*x2 +0.5*x3 +0.5*nrnd
'------华丽的分割线------
group grp1 y x1 x2 x3  '生成组
grp1.stats             '用stats命令报告描述性统计量
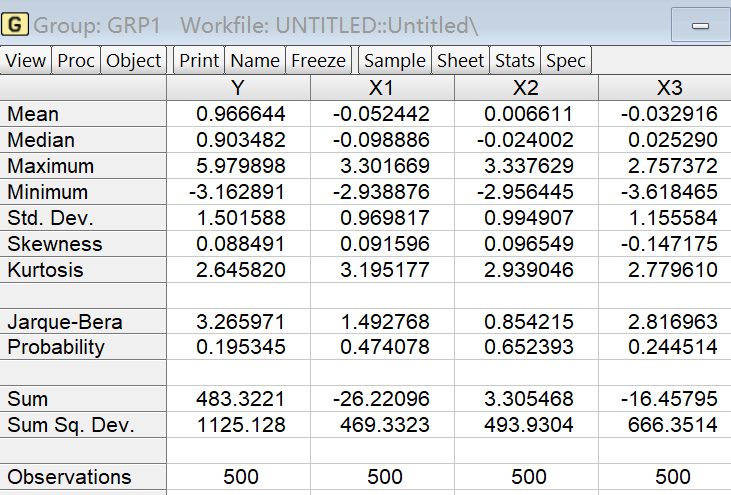
freeze(ds) grp1.stats '将结果存入表ds中倒数第二行的代码等价于在grp1窗口点View/Descriptive Stats/Common Sample。注意,在grp1窗口显示的结果和存入ds中的结果内容是一样的,但长相会有一些区别。下面是grp1窗口显示的结果:
下面是表ds显示的结果:
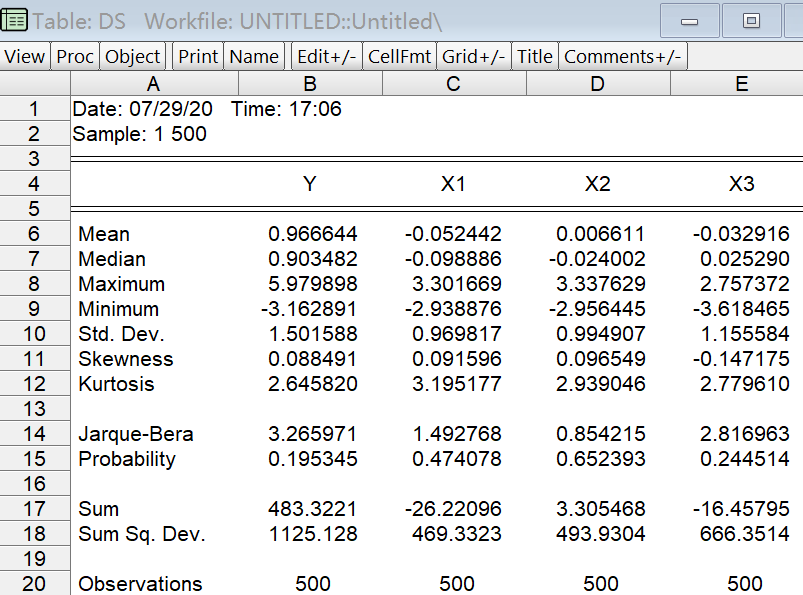
可以看到,stats命令从上到下报告了变量的样本均值、中位数、最大值、最小值、标准差、偏度、峰度、用于检验正态性的JB统计量、JB检验的p值、和、离差平方和、样本量。
相关系数
有些时候,我们会关心变量之间的相关性。例如,进行回归分析时,如果两个自变量高度相关,把它们都放入模型,很可能只有一个显著。因此,建模前看看自变量间的相关性,也许能为我们进行变量选择提供一定的信息。
常用的衡量两个变量间相关性的指标有三个:Peason相关系数、Spearman相关系数和Kendall相关系数。对每一种相关系数,我们感兴趣的值一般有三个:相关系数的数值、检验相关系数为0的统计量的数值、对应检验的p值。我们可以用命令cov报告这些数值:
group grp2 x1 x2 x3    '生成组
'在一张表内报告Peason相关系数、t统计量和对应的p值
grp2.cov(outfmt=single) corr stat prob
'在一张表内报告Spearman相关系数、t统计量和对应的p值
grp2.cov(outfmt=single) rcorr rstat rprob
'分三张表报告Kendall-b相关系数、Score统计量和对应的p值
grp2.cov(outfmt=mult) taub taustat tauprob 上面的代码中括号里的outfmt是cov命令的一个可选参数,它用来设置内容输出的格式(outfmt即output format之意)。outfmt等于single表示所有数值在一张表内报告,等于mult(multiple之意)表示每一类数值单独在一张表中报告。
括号后以空格分开的三个参数,它们的作用是告诉EViews报哪些告量。例如,rcorr表示报告Spearman相关系数,rstat表示报告检验Spearman相关系数为0的t统计量,rprob表示报告对应检验的p值。下面两张图是上面第二行和最后一行代码执行的结果:

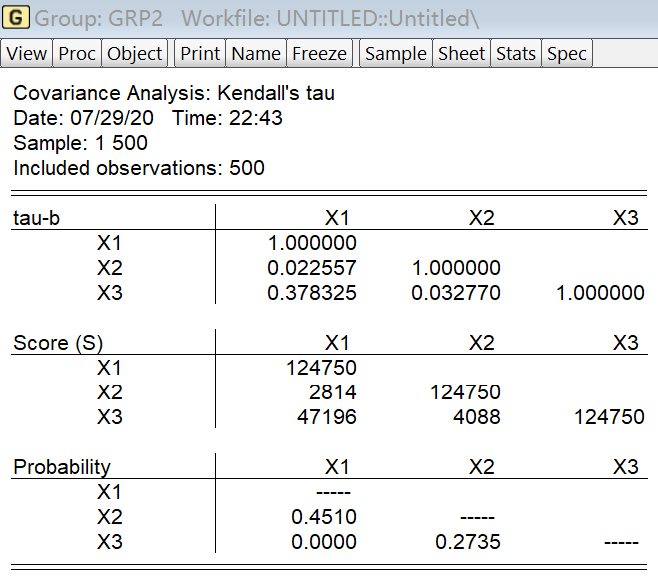
要得到这些表,也可以在鼠标模式下选择grp2窗口的View/Covariance Analysis。保存这些结果,可以选择点击窗口上的Freeze按钮,当然,键盘模式下推荐优先使用freeze命令。
单位根检验
时间序列分析中,各种模型的使用大都要先了解序列是否平稳,因此,检验序列是否有单位根几乎是建模前的必备步骤。要进行单位根检验,我们需要用uroot命令,它能实现五种单位根检验:ADF检验、DF-GLS检验、Phillips-Perron检验、ERS点最优检验、Ng-Perron检验。uroot的用法为:
序列对象.uroot(检验类型, exog = 值, dif = 值, lagmethod = 值)
上面括号里红色的部分是uroot命令的可选参数。检验类型可以是dfgls、pp、ers及np中的一种,对应除ADF检验外的四种检验,如果其缺失,则uroot命令会实施ADF检验(即默认的单位根检验)。
单位根检验的检验假设有两种情形,EViews里把它们称为Intercept(情形1)和Trend and intercept(情形2),它们的区别是:
- 情形1 — 原假设:序列含有单位根 vs 备择假设:序列是平稳的
- 情形2 — 原假设:序列含有单位根 vs 备择假设:序列是趋势平稳的
如果令参数exog等于trend,则uroot命令会检验情形2,如果不使用exog这一参数,则会检验情形1。
参数dif等于1表示对数据的差分做单位根检验,等于2表示对数据的二阶差分做单位根检验,缺失表示直接对数据做单位根检验。
实施除Phillips-Perron检验外的四种检验,都需要设置一个参数:滞后阶数。EViews提供了这样的功能:根据样本量自动设置一个最大的滞后阶数,然后在最大滞后阶数内对比不同滞后阶数设定下的模型的信息准则,进而选出“最优”的滞后阶数。参数lagmethod用来告诉EViews使用哪一种信息准则,如果这一参数缺失,EViews默认会使用SIC(即BIC),如果等于aic或hqc,则会使用AIC或HQIC。
下面是使用uroot命令几个例子:
y.uroot                '对y做情形1的ADF检验,滞后阶数由SIC自动确定
y.uroot(pp,exog=trend) '对y做情形2的pp检验
y.uroot(dfgls,dif=1,lagmethod=hqc)
                       '对y的差分做情形1的DF-GLS检验,滞后阶数由HQIC自动确定
以最后一行代码为例,代码运行后会在series对象窗口中显示如下的表:

表的标题显示了检验的类型。第一行显示了检验的原假设。注意,当前使用的数据是D(Y),即y的一阶差分。第二行的Constant表示检验情形1,如果是Constant, Linear Trend则表示检验情形2。第三行显示了自动选择的“最优”滞后阶数为12、使用的信息准则是HQIC、最大滞后阶数为17。接下来是检验的主要结果。EViews会报告检验统计量的值,以及1%、5%、10%显著水平对应的临界值,有几个检验还会报告检验的p值。
对ADF检验和Phillips-Perron检验,exog还可以设置等于none,这时,uroot命令检验的是下面的假设:
- 情形3 — 原假设:序列含有单位根 vs 备择假设:序列是零期望且平稳的
实际应用中,检验这种情形的场合非常少,所以,其他三种单位根检验在开发时都没有考虑这种情形。
EViews的uroot命令还能做一个检验:KPSS检验,它用于检验下面两种情形:
- 情形1a — 原假设:序列是平稳的 vs 备择假设:序列含有单位根
- 情形2a — 原假设:序列是趋势平稳的 vs 备择假设:序列含有单位根
进行KPSS检验,只需把检验类型设为kpss。另外,KPSS检验不需要设滞后阶数,因此,它不支持使用参数lagmethod。以下是两个例子:
y.uroot(kpss,dif=1)      '对y的差分做情形1a的KPSS检验
y.uroot(kpss,exog=trend) '对y做情形2a的KPSS检验
注意,在EViews 13中,如果做情形2a的KPSS检验,输出结果会显示Null Hypothesis: … is stationary,这实际上是不对的,应该是trend-stationary才对,但是,报告的统计量、临界值等还是可用的。
命令复习
(.)stats:报告描述性统计量(.)cov:报告变量间的相关性(.)uroot:进行单位根检验
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 把上面的代码逐条执行一遍,理解各部分的分析流程,并对比你做出的结果与上面图中展示的结果,它们是否一样?


- 版权声明:本作品使用知识共享(Creative Commons)的署名-非商业性使用-禁止演绎 4.0 国际许可协议。非商业转载请注明出处(作者及原文链接),商业转载请联系作者获得授权。

给站长留言