二值选择模型
对因变量是0-1变量(即取值为0或1的变量)的情形,记因变量等于1的概率为\(p_i =\Pr(y_i=1)\)。线性概率模型假设\(p_i\)是自变量的线性函数:$$p_i=\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i}$$这是导致这一模型无法保证拟合值或预测值是一个概率值的根本原因。为了规避这样的缺点,二值选择模型(binary choice models)采用了这样的假设:$$p_i=F(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})$$其中,\(F(\cdot)\)是某一随机变量的累积分布函数。由于累积分布函数总是介于0和1间的单调不减函数,这就保证了我们总能得到合理的概率拟合值或预测值。
probit、logit和gompit
实际应用中,\(F(\cdot)\)被设为标准正态分布的累积分布函数时,对应的二值选择模型被称为probit模型;\(F(\cdot)\)被设为Logistic分布的累积分布函数时,对应的二值选择模型被称为logit模型。这两个模型是最常用的二值选择模型。EViews还提供了另外一个选择:把\(F(\cdot)\)设为Gumbel分布的累积分布函数。此时,对应的模型被称为gompit模型。
在EViews中,估计这三个模型需要用到binary命令。以EViews安装目录下的Example Files\EV13 Manual Data\Chapter 31 – Discrete and Limited Dependent Variable Models\binary.wf1为例,其中,grade是0-1变量,反映学生的学习成绩有没有进步,这是因变量;psi也是0-1变量,反映学生是否在新教学模式下学习,这是核心的自变量;gpa和tuce是反映学生学习基础的两个控制变量。利用这一数据可以研究新教学模式是否能改进学生的成绩。估计三个模型的代码如下:
equation eq_p           'probit
eq_p.binary grade c psi gpa tuce
equation eq_l           'logit
eq_l.binary(d=l) grade c psi gpa tuce
equation eq_g           'gompit
eq_g.binary(d=x) grade c psi gpa tuce容易看出,模型设置是通过binary的可选参数d来实现的,其被设置为l对应估计logit模型,其被设置为x对应估计gompit模型。下面是probit模型的估计结果:
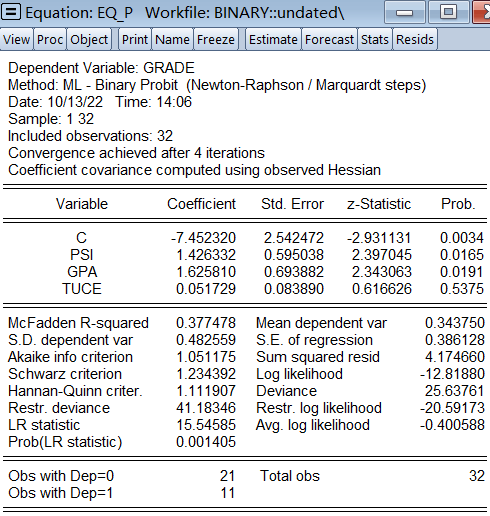
表中,系数估计的部分和之前看过的回归估计的结果类似,我们可以快速地利用p值来判断自变量是否显著。可以看出,psi在5%的显著水平下是显著的,且系数估计值大于0,因此,学生在新教学模式下学习能显著提升成绩进步的概率。系数估计下方报告的统计量中,比较有用的有McFadden R-squared(度量模型拟合优度的指标)、LR statistic和Prob(LR statistic)(检验自变量联合显著性的似然率统计量及其p值)、以及三个信息准则。在表的最下面,报告了因变量等于0或1时对应的样本量。
注意,上表显示估计二值选择模型是基于最大似然法进行的,且估计采用了数值最优化方法。因此,在估计完模型后,一定要检查最优化过程是否收敛。如果没有收敛,我们可通过调整可选参数optmethod、optstep、maxit等的取值来寻找收敛的估计结果。这些参数的含义和用法请参考[回归模型]一讲。
如果我们把最大似然估计看作QMLE,为了实施正确的假设检验,我们可以把可选参数cov设为white。
估计完模型后,如果还需要做其他有关模型参数的检验,仍然可以用wald命令。
估计二值选择模型的鼠标操作是,选中workfile后点击主菜单的Quick/Estimate Equation,或先建一个空的equation对象,然后再点击equation对象窗口上方的Estimate按钮,两种方式都会弹出估计模型的窗口,接下来在Method处选BINARY就能进行协整回归模型的设置并实施估计了。
拟合优度
除了上面提到的McFadden R-squared,另一个在应用中常用的度量拟合优度的统计量是正确预测的百分比(percentage of correct predictions)。
模型估计结束后,我们可以得到\(p_i\)的估计值:$$\hat{p}_i=F(\hat{\beta}_0 + \hat{\beta}_1 x_{1i} + \hat{\beta}_2 x_{2i})$$利用这些估计值,\(y_i\)的预测可以通过下述方式实现:$$\hat{y}_i=\begin{cases}
1 \\
0
\end{cases} \quad \text{if} \quad \begin{matrix}
\hat{p_i}> c \\
\hat{p_i}\leq c
\end{matrix} $$此处的\(c\)是一个事先选好的临界值。在没有其他信息的情况下,一般我们会取\(c\)为0.5。
正确预测的百分比的定义为:$$\frac{\sum_{i=1}^N (1-|y_i -\hat{y}_i|)}{N}$$即通过模型正确预测的样本数占总样本的比例。在EViews,估计完模型后我们可以通过predict命令报告模型的分类表,从中得到正确预测的百分比,例如:
eq_p.predict(0.51) '括号中的数值为选定的临界值代码执行的结果如下图所示:
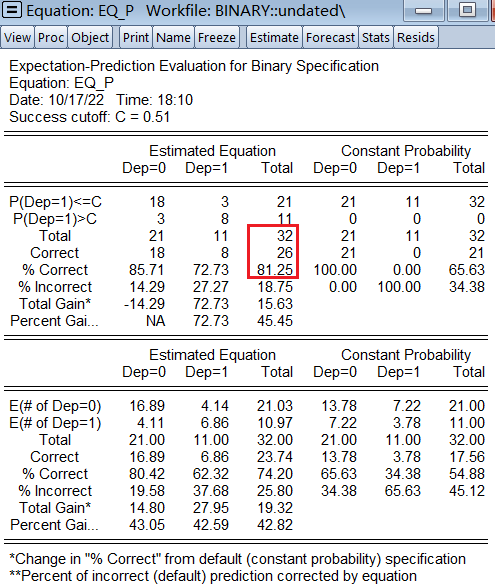
图中,红框部分包含了计算正确预测的百分比的所有信息:32是总样本数,26为正确预测的样本数,81.25%为正确预测的百分比。
边际效应与model对象 
在线性回归模型中,回归系数直接反映了自变量对因变量的边际效应(marginal effects),但是,在二值选择模型中,并不是这样。例如,如果\(x_{1i}\)是0-1变量,则\(x_{1i}\)对\(y_i\)的边际效应为:$$F(\beta_0 + \beta_1 + \beta_2 x_{2i})-F(\beta_0 + \beta_2 x_{2i})$$如果\(x_{1i}\)是连续变量,则\(x_{1i}\)对\(y_i\)的边际效应为\(F(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})\)对\(x_{1i}\)的导函数:$$\beta_1f(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})$$其中,\(f(\cdot)\)为\(F(\cdot)\)对应的概率密度函数。显然,对二值选择模型,边际效应不是一个常数,而是一个函数。为了描述自变量对因变量的平均影响,我们可以使用所有自变量取样本平均值时的边际效应,其被称为平均边际效应(average marginal effects)。
在EViews中,要计算二值选择模型在自变量取特定值时的边际效应,我们可以通过model对象(模型对象)来实现。model对象可以把若干个估计好的模型综合在一起,进而实现更复杂的预测、可视化等功能,这里的应用仅是牛刀小试。
建立model对象需要用命令model:
model me       '创建模型对象me
me.merge eq_p '把模型eq_p纳入memodel对象建立好后,我们需要选择一个方案(scenario)来完成我们想要做的事情。任何一个新建的model对象都会包含三个方案:Actuals、Baseline和Scenario 1,其中,第三个是可以自由修改的方案,我们可以选择这个方案开始我们的分析,也可以自建一个新的方案:
me.scenlist                '列出me对象中的方案(不显示Actuals)
me.scenario "scenario 1"   '选择方案Scenario 1
me.scenario(n,a="_2") "s2" '生成方案s2
me.scenario "s2" '选择方案s2方案选好后,我们需要重写(override)变量,即告诉EViews哪些自变量需要取特定的数值。例如,如果我们要计算psi的平均边际效应,我们需要把gpa和tuce取到它们的样本平均值上,然后分别计算psi取1和取0时grade等于1的概率,再做差。所以,我们需要对psi、gpa和tuce进行重写:
me.override psi gpa tuce '重写变量变量重写后,”变量名_2″将是方案s2使用的自变量的变量名,这是因为在上面生成s2的代码中,我们设定了a=”_2″。接下来,我们要对这些重写的变量进行赋值:
series psi_2 = 1
series gpa_2 = @mean(gpa)
series tuce_2 = @mean(tuce)然后,利用solve命令就可以得到基于重写变量算出的grade等于1的概率,其会被存入新生成的名为”因变量名_2″(即grade_2)的series变量中:
me.solve  '解模型对象,即根据重写的变量计算
          'Pr(grade=1),并将其存入grade_2中
          '注意,grade_2中所有的值都是相同的
scalar p1 = grade_2(1)  '生成标量p1存放Pr(grade=1|psi=1)
最后,我们需要计算psi=0的情形,进而算出平均边际效应:
series psi_2 = 0
me.solve
scalar p0 = grade_2(1)  '生成标量p1存放Pr(grade=1|psi=0)
scalar ame = p1 - p0    'psi的平均边际效应(值为0.464426)
计算连续变量的边际效应,可以利用分布函数对应的概率密度函数精确计算,也可以通过model对象近似计算。记\(F(x_{1i},x_{2i})=F(\beta_0 + \beta_1 x_{1i} + \beta_2 x_{2i})\),近似计算的原理为:当\(\Delta x\)很小时,\(x_{1i}\)对\(y_i\)的边际效应约等于$$\frac{F(x_{1i}+\Delta x,x_{2i})-F(x_{1i}-\Delta x,x_{2i})}{2\Delta x}$$例如,gpa的平均边际效应可以通过下面的代码近似计算:
series psi_2 = @mean(psi)
series gpa_2 = @mean(gpa)+0.00001
me.solve
scalar p1 = grade_2(1)
series gpa_2 = @mean(gpa)-0.00001
me.solve
scalar p0 = grade_2(1)
scalar ame = p1 - p0
ame = ame/0.00002       'gpa的平均边际效应(值为0.53)
需要注意的是,由于计算精度的问题,采用model对象做近似计算时,\(\Delta x\)不宜取得太小。
model对象也能让我们以更丰富的形式展示分析结果。例如,如果我们要想看在tuce取平均值、psi取0和1时,grade等于1的概率如何随gpa的变化而变化,我们可以通过如下代码来展示对应的概率变化图:
series psi_2 = 1
'利用@trend函数均匀生成在2到4间的数值,存入gpa_2
series gpa_2 = 2+(4-2)*@trend/(@obs(gpa)-1)
series tuce_2 = @mean(tuce)
me.solve
series p_1 = grade_2
series psi_2 = 0
me.solve
series p_0 = grade_2
group g1 gpa_2 p_1 p_0   '生成组对象
g1.xyline
代码执行的结果如下图所示:
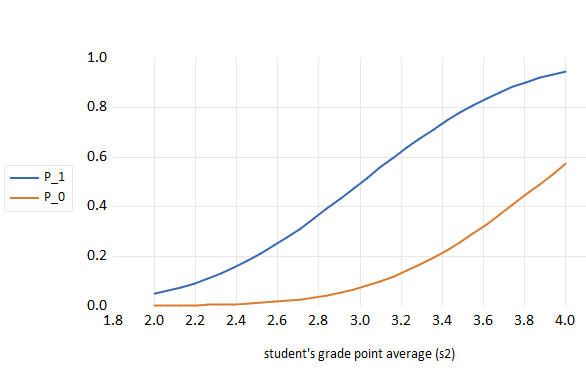
由图可以看出,当gpa较低时,新教学模式提升学生成绩的效力较弱。
命令复习
binary:估计二值选择模型.predict:报告二值选择模型的分类表model:创建model对象.merge:把已建立的模型纳入model对象.scenlist:列出model对象中的方案.scenario:选择、创建方案.override:重写变量.solve:解model对象
[注] ( . )命令表示命令可单独使用,也可跟在对象后使用;.命令表示命令只能跟在对象后使用。
练习
- 上述研究案例的logit模型的正确预测的百分比是多少?
- 估计上述研究案例的logit模型的方法如果是QMLE,检验psi显著性的p值是多少?
- 对上述研究案例的logit模型,计算psi的平均边际效应。


- 版权声明:本作品使用知识共享(Creative Commons)的署名-非商业性使用-禁止演绎 4.0 国际许可协议。非商业转载请注明出处(作者及原文链接),商业转载请联系作者获得授权。

给站长留言